Unternehmen nutzen heutzutage selten nur eine einzige Datenquelle. Ein Kunde kann eine Website besuchen, eine E-Mail öffnen, den Kundenservice kontaktieren, ein Produkt verwenden, einen Kaufvorgang abbrechen und schließlich den Vertrieb kontaktieren. Jede dieser Interaktionen hinterlässt einen Datensatz in einem anderen System, oft in einem anderen Format.
Ein Data Lake bietet Unternehmen die Möglichkeit, Datensätze zusammenzuführen, ohne dass jede Quelle zuvor einer vordefinierten Struktur entsprechen muss. Diese Flexibilität ist besonders nützlich, wenn die Fragestellungen noch nicht geklärt sind, wenn die Daten Formate wie Audio oder Protokolle umfassen oder wenn große historische Datensätze für Analysen aufbewahrt werden müssen.
Doch alles zu speichern bedeutet nicht automatisch, alles nutzbar zu machen. Ohne Katalogisierung, Qualitätskontrollen, Zugriffsregeln und klare Anwendungsfälle kann ein Data Lake zu einem weiteren Datensilo werden.
Was ist ein Data Lake?
Ein Data Lake ist eine zentrale Speicherumgebung, die große Datenmengen in ihrer ursprünglichen oder nahezu ursprünglichen Form speichert. Anstatt vor der Speicherung jedes Datenset einer festen Struktur zuzuordnen, kann er verschiedene Informationstypen speichern und die Daten erst dann strukturieren, wenn sie für die Analyse benötigt werden.
Dadurch eignet es sich für Daten wie:
- Strukturierte Daten: Tabellen aus Datenbanken, Tabellenkalkulationen, Transaktionen und anderen Datensätzen, die in definierte Felder unterteilt sind.
- Halbstrukturierte Daten: JSON, XML, Anwendungsereignisse und Protokolle, die Bezeichnungen oder Schlüssel enthalten, aber keiner festen relationalen Struktur folgen.
- Unstrukturierte Daten: Anrufaufzeichnungen, Dokumente, Bilder, Videos, Transkripte und andere Inhalte, die nicht von Natur aus in Zeilen und Spalten passen.
Die wichtige Unterscheidung ist wenn die Daten strukturiert sind.
Ein traditionelles relationales System definiert das Datenmodell in der Regel, bevor Informationen gespeichert werden. Ein Data Lake hingegen kann die Quelldaten zuerst speichern und erst dann festlegen, wie diese interpretiert oder transformiert werden, wenn ein Analyst, eine Anwendung oder ein Machine-Learning-Prozess sie benötigt.
Diese Flexibilität erleichtert die Integration neuer Datenquellen. Gleichzeitig bringt sie aber auch Verantwortung mit sich: Jemand muss wissen, was die Daten bedeuten, woher sie stammen, ob sie zuverlässig sind und wer sie nutzen darf.
Data-Lake-Workflow
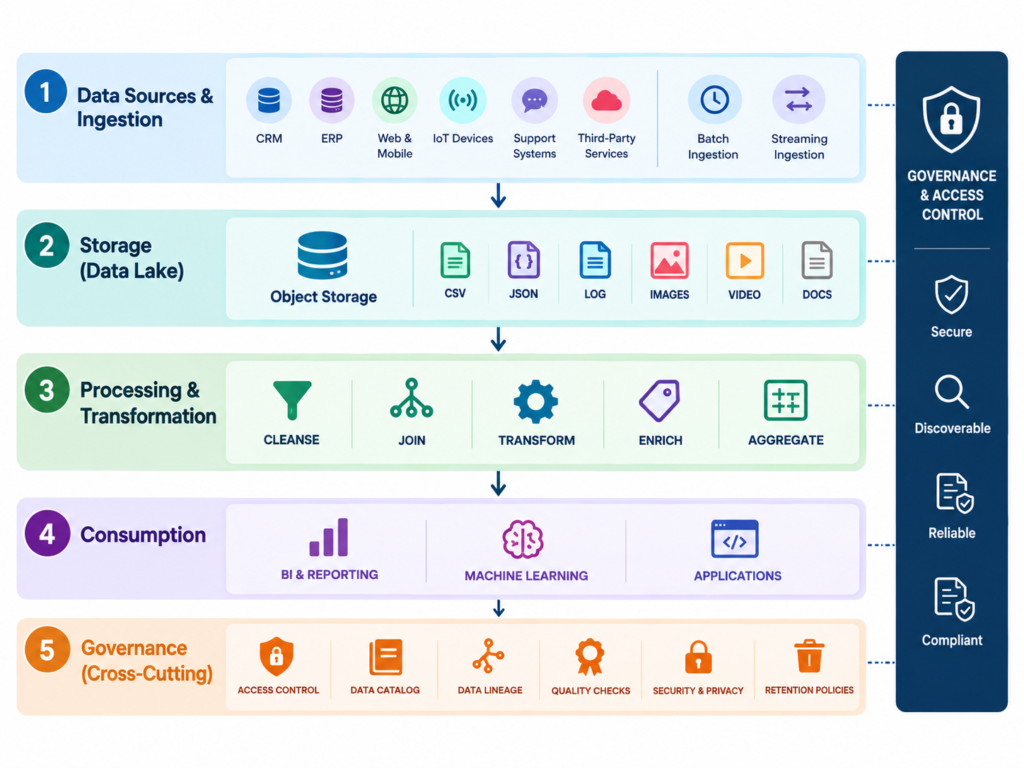
Ein Data Lake durchläuft Daten in mehreren miteinander verbundenen Phasen, von der Erfassung bis zur Analyse. Jede Phase hat eine spezifische Aufgabe, und die Datenverwaltung erstreckt sich über den gesamten Prozess.
- Sammeln Sie die Daten: Die Daten stammen aus CRM- und ERP-Systemen, Websites, mobilen Apps, IoT-Geräten, Zahlungsplattformen und Drittanbieterquellen.
- Daten einlesen: Ein Datenaufnahmeprozess überträgt Daten in den Datensee entweder in geplanten Batches oder kontinuierlichen Datenströmen, je nachdem, wie schnell die Daten verfügbar sein müssen.
- Speichern Sie die Daten: Der Datensee speichert Daten in ihrer ursprünglichen oder nahezu ursprünglichen Form. Cloud-Objektspeicher werden häufig verwendet, da sie große Datenmengen und verschiedene Dateiformate verarbeiten können.
- Daten verarbeiten: Analytische und maschinelle Lernprozesse bereinigen, kombinieren, transformieren oder strukturieren die Daten für eine spezifische Fragestellung oder einen Anwendungsfall.
- Nutzen Sie die Daten: Analysten können die Daten mithilfe von BI-Tools abfragen, während Data Scientists und Anwendungen sie für Analysen, maschinelles Lernen und andere Workloads nutzen können.
- Daten verwalten: Zugriffskontrollen, Kataloge, Datenherkunft, Qualitätsprüfungen, Aufbewahrungsregeln und Sicherheitsmaßnahmen tragen dazu bei, dass die Daten korrekt, auffindbar und angemessen geschützt sind.
Die Kernaussage ist, dass Speicherung und Interpretation sind getrenntDieselbe Rohdatenquelle kann daher für verschiedene analytische Zwecke genutzt werden, ohne dass die Originaldaten für einen bestimmten Bericht dauerhaft umgestaltet werden müssen.
Wichtige Komponenten eines Data Lakes
Ein funktionierender Data Lake benötigt mehr als nur einen großen Speicherplatz. Daten müssen zuverlässig erfasst, auffindbar bleiben, effizient verarbeitet und den Nutzern in einem nutzbaren Format zur Verfügung gestellt werden. Die sechs folgenden Komponenten bilden die Kernarchitektur.
1. Datenquellen
Quellen liefern den Rohstoff für den See.
Typische Beispiele sind:
- CRM-Datensätze
- ERP-Transaktionen
- Website-Ereignisse
- Anwendungsprotokolle
- IoT-Telemetrie
- Kundenbetreuungssysteme
- Marketingplattformen
- Datensätze von Drittanbietern
- Dokumente, Audio, Bilder und Videos
Der Nutzen einer zusätzlichen Datenquelle hängt davon ab, welche Erkenntnisse das Unternehmen daraus gewinnen möchte. Das Sammeln aller verfügbaren Ereignisse ohne konkreten Zweck erhöht den Speicher- und Verwaltungsaufwand, ohne die Analyse zwangsläufig zu verbessern.
2. Datenaufnahme
Die Datenaufnahme überträgt Daten von Quellsystemen in den Datensee. Zwei gängige Ansätze sind:
- Chargenweise Aufnahme: Die Datenübertragung erfolgt in festgelegten Abständen. Dies eignet sich gut für Berichtszwecke und Anwendungsfälle, in denen stündliche oder tägliche Aktualisierungen ausreichen.
- Streaming-Erfassung: Ereignisse werden kontinuierlich oder mit sehr geringer Latenz übertragen. Dies ist besonders geeignet, wenn Entscheidungen von aktuellen Ereignissen abhängen, wie beispielsweise bei Echtzeitüberwachung oder ereignisgesteuerten Anwendungen.
Streaming ist nicht automatisch besser. Es bringt zusätzliche Infrastruktur und operative Komplexität mit sich, daher sollte der Business Case entscheiden, ob die geringere Latenz tatsächlich von Vorteil ist.
3 Lagerung
Der Speicher enthält die eingehenden Daten und die zugehörigen Metadaten. Objektspeicher sind weit verbreitet, da sie große Datensätze und verschiedene Dateitypen verarbeiten können, ohne dass jede Datei demselben Schema entsprechen muss.
Die Speicherkosten sind jedoch nur ein Teil der Wirtschaftlichkeit. Verarbeitung, Datentransfer, Sicherheit, Überwachung, Governance und Abfrage-Workloads können ebenfalls erheblich zu den Gesamtbetriebskosten eines Data Lakes beitragen.
4. wird bearbeitet
Die Verarbeitung wandelt gespeicherte Daten in eine für einen bestimmten Zweck geeignete Form um. Beispielsweise könnte ein Unternehmen:
- Entfernen doppelter Datensätze
- Zeitstempel standardisieren
- Kunden-IDs systemübergreifend verknüpfen
- Stimmungslage aus Supportgesprächen extrahieren
- Ereignisse in Verhaltensmerkmale umwandeln
- Gesamttransaktionen
- Trainingsdaten für ein maschinelles Lernmodell vorbereiten
Die Rohdaten können erhalten bleiben, während diese Transformationen für spezifische Analysezwecke erstellt werden.
5. Führung
Governance entscheidet darüber, ob die Menschen den Daten tatsächlich vertrauen und sie sicher nutzen können.
Es kann umfassen:
- Datenkataloge
- Eigentumsaufzeichnungen
- Datenherkunft
- Qualitätsprüfungen
- Zugangskontrollen
- Datenschutzbestimmungen
- Aufbewahrungsrichtlinien
- Buchungsprotokolle
Dies ist besonders wichtig, wenn der Datenspeicher Kundendaten enthält. Die zentrale Datenspeicherung beseitigt nicht die mit diesen Daten verbundenen Datenschutz-, Sicherheits- und Compliance-Verpflichtungen.
6. Verbrauch
Die Nutzungsschicht ist der Bereich, in dem gespeicherte Daten nutzbar werden. Verschiedene Benutzer können dieselben zugrunde liegenden Informationen auf folgende Weise nutzen:
- BI-Dashboards
- SQL-Abfragen
- Analytische Anwendungen
- Pipelines für maschinelles Lernen
- Data Science-Notizbücher
- Betriebliche Anwendungen
Ein Data Lake ist nur dann erfolgreich, wenn diese Ebene zu nützlichen Analysen oder Maßnahmen führt. Große Mengen gespeicherter Daten sind nicht von selbst ein Ergebnis.
Data Lake vs. Data Warehouse
Data Lakes und Data Warehouses lösen verwandte, aber unterschiedliche Probleme. Ein Warehouse ist in der Regel auf strukturierte, wiederholbare analytische Fragestellungen ausgerichtet, während ein Lake mehr Flexibilität für rohe, vielfältige und explorative Daten bietet.
| Attribut | Datensee | Data Warehousing |
| Daten akzeptiert | Strukturiert, halbstrukturiert, unstrukturiert | Primär strukturiert |
| Datenstatus | Oftmals in Rohform erhalten | Gereinigt und verwandelt |
| Wenn Struktur angewendet wird | Typischerweise während der Analyse oder Transformation | Vor oder während des Ladens |
| Gemeinsame Benutzer | Datenwissenschaftler, Ingenieure, Analysten | Analysten, Geschäftsteams |
| Typische Stärke | Exploration und vielfältige Daten | Konsistente Berichterstattung und Analysen |
| Leistung abfragen | Hängt von der Architektur und der Arbeitslast ab. | Üblicherweise optimiert für wiederkehrende Abfragen |
| Häufige Anwendungsfälle | KI, Exploration, Verhaltensdaten | Business Intelligence, Finanzberichterstattung, operative Analyse |
Der Unterschied wird deutlicher, wenn man sich die Fragen ansieht, die jedes System beantworten soll.
Ein Lagerhaus eignet sich gut für Fragen wie:
- Wie hoch waren die Umsätze nach Regionen im letzten Quartal?
- Welche Produktkategorie erzielte die höchste Gewinnspanne?
- Wie hat sich die Kundenabwanderung im vergangenen Jahr verändert?
Diese Fragen sind im Voraus bekannt, sodass die Daten entsprechend bereinigt und organisiert werden können.
Ein See ist dann besonders nützlich, wenn das Unternehmen Informationen erkunden möchte, die nicht nahtlos in vordefinierte Strukturen passen.
Beispielsweise:
- Enthalten Supportgespräche Signale, die auf eine mögliche Kundenabwanderung hindeuten?
- Hat die Produktnutzung Einfluss auf die Erneuerung?
- Welche Abfolge von Website-Aktionen ist mit einer Conversion verbunden?
- Können Anrufaufzeichnungen nützliche Informationen für ein Umsatzprognosemodell liefern?
Viele Organisationen nutzen daher beides. Das Data Warehouse unterstützt etablierte Berichtsfunktionen, während der Data Lake ein umfassenderes Umfeld für Exploration, maschinelles Lernen und vielfältige Daten bietet.
Wichtiger Hinweis: Ein Data Lake ist eine analytische Datenumgebung. Er kann Kundeninformationen speichern und verarbeiten, ersetzt aber nicht die operativen Funktionen, die Leads, Deals, Fälle, Kampagnen oder Kundeninteraktionen verwalten – wie beispielsweise … CRM können.
Vorteile eines Data Lake
Der wichtigste Grund für den Aufbau eines Data Lakes liegt nicht allein in der Menge der speicherbaren Daten. Sein Wert ergibt sich vielmehr aus der Speicherung verschiedenster Informationen und deren Analyse, um Fragen zu beantworten, die bestehende operative Systeme nicht effizient beantworten können.
Skalieren ohne jede Quelle neu zu gestalten
Ein Data Lake kann wachsende Datenmengen aufnehmen, ohne dass jeder neue Datensatz in ein bestehendes relationales Schema passen muss.
Das ist nützlich, wenn ein Unternehmen Folgendes hinzufügt:
- Eine neue Anwendung
- Ein neues Produkt
- Ein neuer Kundenkanal
- Ein übernommenes Unternehmen
- Eine neue Quelle für Verhaltensdaten
Die neue Datenquelle kann eingelesen und katalogisiert werden, ohne dass zuvor jede bestehende Analysetabelle neu gestaltet werden muss.
Unterstützung für verschiedene Datentypen
Viele nützliche Geschäftssignale kommen nicht als ordentliche Zeilen und Spalten an.
Ein See kann Folgendes zurückhalten:
- Aufzeichnungen aufrufen
- Support-Transkripte
- Produktbilder
- Unterlagen
- Website-Ereignisse
- Anwendungsprotokolle
- IoT-Telemetrie
Diese Quellen können später in Merkmale oder Datensätze für spezifische Analysezwecke umgewandelt werden.
Eine flexible Grundlage für KI und maschinelles Lernen
KI-Projekte benötigen häufig historische Daten aus verschiedenen Quellen. Ein Data Lake kann eine zentrale Umgebung bieten, um diese Informationen zu speichern und für die Modellentwicklung aufzubereiten.
Mehr Daten bedeuten aber nicht automatisch eine bessere KI.
Die Daten müssen noch vorliegen:
- Relevant für die Vorhersage
- Korrekt beschriftet, wo erforderlich
- Konsequent genug, um analysiert zu werden
- Repräsentativ für die modellierte Population
- Richtig regiert
- Für den Modellierungsworkflow zugänglich.
Der Vorteil eines Sees besteht darin, dass er ein breiteres Spektrum potenzieller Signale speichern kann, bevor das Unternehmen weiß, welche davon sich als nützlich erweisen werden.
Reduzierung analytischer Datensilos
Ein Datensee kann Informationen aus verschiedenen Systemen in einer gemeinsamen Analyseumgebung zusammenführen.
Ein Einzelhändler könnte beispielsweise Folgendes kombinieren:
Transaktionen + Website-Verhalten + Marketing-Engagement + Kundensupport
anstatt vier Systeme nach vier separaten Berichten zu fragen.
Das beseitigt zwar nicht jedes Integrationsproblem, kann aber wiederholte Exporte und manuelle Abgleiche bei analytischen Workloads reduzieren.
Verwechseln Sie Speicherplatz nicht mit Benutzerfreundlichkeit: Ein Datensee kann zu einem „Datensumpf“ werden, wenn Datensätze schlecht dokumentiert, schwer auffindbar, unzuverlässig oder teuer abzufragen sind. Governance, Katalogisierung, Qualitätskontrollen und Datenverantwortung sind daher integraler Bestandteil der Architektur und keine optionalen Aufräumarbeiten.
Data Lake-Anwendungsfälle
Data Lakes werden dann wertvoll, wenn ein Unternehmen Informationen analysieren muss, die zu vielfältig, zu umfangreich, zu historisch oder zu verteilt sind, als dass seine bestehenden Systeme sie effizient verarbeiten könnten.
Systemübergreifende Analysen
Ein See kann Informationen aus Systemen zusammenführen, die für unterschiedliche operative Zwecke konzipiert wurden.
Ein Unternehmen könnte beispielsweise Folgendes analysieren:
- Kaufhistorie
- Website-Aktivität
- Marketingengagement
- Unterstützungsinteraktionen
- Produktverwendung
in einem einzigen analytischen Arbeitsablauf.
Dadurch können Zusammenhänge aufgezeigt werden, die bei einer unabhängigen Analyse der einzelnen Systeme schwer zu erkennen sind.
Maschinelles Lernen und KI
Ein See kann ein zentrales Umfeld für die Aufbereitung historischer Daten für maschinelles Lernen bieten.
Mögliche Anwendungen sind:
- Abwanderungsvorhersage
- Nachfragevorhersage
- Empfehlungssysteme
- Entdeckung eines Betruges
- Kundenpräferenzmodellierung
- Vorausschauende Wartung
Der Datensee erzeugt das Modell nicht selbst. Er bietet Speicherplatz und Zugriff auf die Daten, die zum Erstellen, Testen und Verbessern von Modellen benötigt werden.
Kundenverhaltensanalyse
Operative CRM-Systeme erfassen üblicherweise Informationen, die zur Verwaltung von Kundenbeziehungen benötigt werden. Ein Datensee kann einen breiteren Strom von Verhaltensereignissen speichern.
Diese können beinhalten:
- Website-Reisen
- Suchaktivität
- Sitzungsereignisse
- Wagenabgabe
- Produktverwendung
- E-Mail-Interaktionen
- Unterstützungsaktivität
Die Analyse dieser Ereignisse im Zeitverlauf kann Unternehmen dabei helfen, Muster zu erkennen, die in einzelnen CRM-Datensätzen nicht sichtbar sind.
Datenkonsolidierung nach Akquisitionen
Nach Unternehmensübernahmen verfügen Unternehmen häufig über eine Vielzahl von CRM-, ERP-, Analyse- und Betriebssystemen. Ein Data Lake bietet eine gemeinsame Analyseumgebung, ohne dass jedes Altsystem sofort migriert werden muss. Dies ist besonders nützlich, wenn es zunächst um die Analyse des fusionierten Unternehmens geht, während die langfristige Systemkonsolidierung noch geplant wird.
Wie Data Lakes KI-gestütztes CRM unterstützen
Ein CRM-System enthält die Informationen, die ein Unternehmen zur Verwaltung seiner Kundenbeziehungen benötigt. Ein Data Lake kann eine wesentlich umfassendere Historie des Kundenverhaltens, der Produktnutzung, der digitalen Aktivitäten und der Interaktionen enthalten.
Die Verknüpfung beider Systeme kann KI-Systemen daher zusätzliche Analysesignale liefern. Ein CRM-Modell verbessert sich durch einen solchen Datenpool jedoch nicht automatisch. Die Daten müssen zunächst relevant sein, dem richtigen Kunden oder Konto zugeordnet, verwaltet und für die Modellierung oder den operativen Workflow verfügbar gemacht werden.
Fügen Sie Kontext über den CRM-Datensatz hinaus hinzu.
Das CRM-Datenbankstruktur kann Kontaktinformationen, Transaktionshistorie, Aktivitäten, Fälle und andere Beziehungsdaten enthalten.
Ein Data Lake kann Informationen hinzufügen, die das CRM normalerweise nicht vollständig speichert, wie zum Beispiel:
- Detaillierte Website-Veranstaltungen
- Produktverwendung
- Aufzeichnungen aufrufen
- Anwendungsprotokolle
- Historische Verhaltensereignisse
Zusammengenommen ermöglichen diese Quellen einen umfassenderen Überblick über das Geschehen vor, während und nach einer Kundeninteraktion.
Geben Sie Vorhersagemodellen relevantere Signale
Prädiktive KI-Modelle kann historische Muster nutzen, um wahrscheinliche Ergebnisse abzuschätzen.
Ein Churn-Modell könnte beispielsweise Kundensupportaktivitäten, Produktnutzung, Kundenbindung und Kaufhistorie berücksichtigen, anstatt sich auf ein einzelnes Signal zu verlassen.
Das entscheidende Wort ist relevant. Das Hinzufügen tausender unabhängiger Felder kann die Komplexität erhöhen, ohne die Vorhersage zu verbessern. Gute KI basiert auf nützlichen Signalen, sauberen Daten, geeigneter Modellierung und kontinuierlicher Evaluierung.
Kundensegmentierung verbessern
Kundensegmentierungsmodelle kann stärker auf das Verhalten ausgerichtet werden, wenn zusätzliche Kundenereignisse verfügbar sind.
Anstatt Kunden nur nach ihren Käufen zu gruppieren, könnte ein Unternehmen zwischen folgenden Kundengruppen unterscheiden:
- Ich stöbere regelmäßig, kaufe aber selten.
- Kaufen Sie regelmäßig ein und beteiligen Sie sich an Kampagnen.
- Ich nutze das Produkt häufig, habe die Nutzung aber in letzter Zeit reduziert.
- Kontaktieren Sie den Support wiederholt vor der Verlängerung.
Diese Muster ermöglichen ein nützlicheres Targeting als demografische oder rein transaktionsbezogene Segmente.
Bessere Eingaben in die CRM-Automatisierung einspeisen
KI-CRM-Funktionen kann Kunden- und Interaktionsdaten nutzen, um Empfehlungen, Vorhersagen und andere automatisierte Arbeitsabläufe zu unterstützen.
Die Analyseebene und das CRM haben nach wie vor unterschiedliche Aufgaben.
Der Data Lake hilft bei der Aufbereitung und Analyse umfangreicherer Datensätze. Im CRM werden die gewonnenen Erkenntnisse operativ umgesetzt, beispielsweise um einen Kunden zu identifizieren, der Aufmerksamkeit benötigt, oder um das nächste Vorgehen zu empfehlen.
Dieser letzte Schritt ist entscheidend. Eine Erkenntnis, die nur in einer analytischen Umgebung existiert, verbessert das Kundenerlebnis erst dann, wenn jemand oder etwas darauf reagiert.
Vor dem Aufbau eines Data Lakes: Prüfen Sie, ob das Problem tatsächlich einen Data Lake erfordert. Wenn Ihr Unternehmen seine Fragen zum Reporting und Kundenmanagement mit einem bestehenden CRM-, Data-Warehouse- oder BI-System oder durch direkte Integrationen beantworten kann, kann ein Data Lake unnötigen Aufwand in den Bereichen Speicherung, Entwicklung, Sicherheit und Governance verursachen.
Implementierung eines Data Lakes
Ein Data-Lake-Projekt sollte mit den zu beantwortenden Geschäftsfragen beginnen, nicht mit der Entscheidung über den benötigten Speicherplatz. Die effektivsten Implementierungen legen zudem frühzeitig Governance und Verantwortlichkeiten fest, anstatt diese erst im Nachhinein zu beheben.
Beginnen Sie mit konkreten Fragen
Definiere die ersten Anwendungsfälle, bevor du Daten sammelst.
Beispielsweise:
- Welche Kunden neigen am ehesten zur Abwanderung?
- Welches Produktverhalten sagt eine Verlängerung voraus?
- Welche Kampagneninteraktionen beeinflussen die Konversion?
- Welche Unterstützungsmuster deuten auf Unzufriedenheit hin?
Eine klare Fragestellung hilft dabei, festzustellen, welche Quellen tatsächlich zur ersten Version des Sees gehören.
Katalogdaten von Anfang an
Jeder Datensatz sollte grundlegende Informationen enthalten über:
- Was es enthält
- Woher es kam
- Wem gehört es?
- Wie oft es aktualisiert wird
- Wie zuverlässig es ist
- Wer kann darauf zugreifen?
Ohne diese Informationen wird es schwierig, eine wachsende Sammlung von Dateien zu interpretieren.
Sicherheits- und Zugriffskontrollen anwenden
Kunden- und Mitarbeiterdaten können personenbezogene oder anderweitig sensible Informationen enthalten.
Die Zugangsrichtlinien sollten daher Folgendes festlegen:
- Wer hat Zugriff auf die einzelnen Datensätze?
- Welche Bereiche benötigen zusätzlichen Schutz?
- Wie lange sollten Informationen aufbewahrt werden?
- Wie die Datennutzung geprüft wird
- Wie sensible Informationen maskiert oder eingeschränkt werden
Die Kontrollmechanismen sollten für den See als Teil des umfassenderen Datenumfelds gelten und nicht erst im Nachhinein berücksichtigt werden.
Das gleiche Prinzip gilt auch für CRM-Umgebungen. Zum Beispiel: CRM-Sicherheitskontrollen sind so konzipiert, dass der Zugriff auf Kunden- und Geschäftsdaten gemäß den organisatorischen Anforderungen eingeschränkt wird.
Wählen Sie je nach Bedarf zwischen Batch- und Streaming-Verarbeitung.
Wählen Sie Streaming nicht nur, weil es fortschrittlicher klingt. Die Stapelverarbeitung kann ausreichend sein, wenn das Unternehmen tägliche oder stündliche Änderungen analysiert. Streaming ist dann sinnvoller, wenn Entscheidungen von Ereignissen abhängen, die innerhalb von Sekunden oder Minuten eintreffen. Die richtige Wahl hängt von den geschäftlichen Auswirkungen der Latenz ab.
Nutzungsmessung und Geschäftsergebnisse
Ein Data Lake sollte anhand seiner Ergebnisse und nicht anhand seines Speichervolumens bewertet werden.
Nützliche Maßnahmen sind unter anderem:
- Anzahl aktiver analytischer Anwendungsfälle
- Abfrage- oder Datensatznutzung
- Zeitaufwand für die Datenaufbereitung
- Reduzierung des manuellen Abgleichs
- Modellleistung
- Zeitersparnis bei der Berichterstattung
- Auswirkungen auf Umsatz oder Kundenbindung, sofern messbar
Ein Datensee, der Petabytes an Daten enthält, aber keine sinnvollen Entscheidungen ermöglicht, ist keine erfolgreiche Datenplattform.
Wie Vtiger CRM-Daten in konkrete Maßnahmen umsetzt
Ein Data Lake und ein CRM-System haben unterschiedliche Aufgaben. Ein Data Lake unterstützt umfangreichere Analyseprozesse, während ein CRM-System Teams bei der Verwaltung von Kundeninformationen, Vertriebsaktivitäten, Serviceinteraktionen und Nachfassaktionen unterstützt. Vtiger konzentriert sich darauf, die bereits im CRM-System vorhandenen Daten in nützliche Entscheidungen umzuwandeln. Kalkül AI Es nutzt CRM-Daten und Kundeninteraktionen, um vorausschauende Erkenntnisse und Empfehlungen zu liefern. Es unterstützt Funktionen wie prädiktives Lead-Scoring, Umsatzprognosen, Gesprächsanalyse und Empfehlungen für die jeweils beste nächste Aktion.
Häufig gestellte Fragen (FAQs)
Frage 1: Was ist ein Data Lake?
Ein Data Lake ist eine zentrale Speicherumgebung für große Mengen strukturierter, semistrukturierter und unstrukturierter Daten. Er kann Daten in ihrer ursprünglichen Form speichern und sie später strukturieren, wenn sie für die Analyse aufbereitet werden.
Frage 2: Welche Vorteile bietet ein Data Lake?
Ein Data Lake kann verschiedene Datentypen aufnehmen, große Datenmengen verarbeiten, historische Informationen für Analysen speichern und eine gemeinsame Umgebung für Daten aus mehreren Systemen bereitstellen. Diese Vorteile hängen von effektiver Governance, Sicherheit, Katalogisierung und Datenqualität ab.
Frage 3: Was sind gängige Anwendungsfälle für Data Lakes?
Zu den typischen Anwendungsfällen gehören systemübergreifende Analysen, maschinelles Lernen, Kundenverhaltensanalysen, Bedarfsprognosen, Empfehlungssysteme und die Konsolidierung analytischer Daten aus mehreren Geschäftsbereichen oder Altsystemen.
Frage 4: Worin besteht der Unterschied zwischen einem Data Lake und einem Data Warehouse?
Ein Data Warehouse speichert in der Regel strukturierte und aufbereitete Daten für festgelegte Analyse- und Berichtszwecke. Ein Data Lake bietet hingegen mehr Flexibilität für Rohdaten und heterogene Daten und eignet sich daher für exploratives Arbeiten, maschinelles Lernen und Anwendungsfälle, in denen die benötigte Datenstruktur nicht im Voraus bekannt ist.
Frage 5: Wie unterstützt ein Data Lake KI?
Ein Data Lake kann eine zentrale Umgebung zur Speicherung und Aufbereitung historischer Daten aus verschiedenen Quellen bieten. Dadurch erhalten Machine-Learning-Teams Zugriff auf ein breiteres Spektrum relevanter Signale, wobei mehr Daten jedoch nicht automatisch zu einem besseren Modell führen.
Frage 6: Kann ein Data Lake das CRM verbessern?
Ein Data Lake kann zusätzliche Verhaltens-, Produkt- und Interaktionsdaten liefern, die CRM-Analysen und KI-Modelle bereichern können. Die Daten müssen relevant, zuverlässig, korrekt mit Kundendatensätzen verknüpft, verwaltet und dem CRM- oder Modellierungs-Workflow zur Verfügung gestellt werden, bevor sie einen Mehrwert bieten können.
Frage 7. Welche Rolle spielen Data Lakes im KI-gestützten CRM?
Ein Data Lake kann als umfassendere analytische Datenumgebung dienen, während das CRM weiterhin das operative System zur Verwaltung von Kundenbeziehungen bleibt. Erkenntnisse aus breiteren Datensätzen können potenziell CRM-Prognosen, Segmentierungen, Empfehlungen und andere kundenorientierte Maßnahmen unterstützen.
Frage 8: Benötigt jedes Unternehmen einen Data Lake?
Nein. Ein Data Lake ist am nützlichsten, wenn ein Unternehmen über große oder vielfältige Datensätze verfügt, die bestehende Systeme nicht effizient analysieren können, über mehrere Datenquellen, die gemeinsam untersucht werden müssen, oder über Anforderungen an maschinelles Lernen und Analysen, die den zusätzlichen Aufwand für Entwicklung und Governance rechtfertigen.