Bisnis jarang lagi hanya mengandalkan satu sumber data. Seorang pelanggan mungkin menjelajahi situs web, membuka email, berbicara dengan layanan pelanggan, menggunakan produk, meninggalkan keranjang belanja, dan akhirnya menghubungi bagian penjualan. Setiap interaksi dapat meninggalkan catatan di sistem yang berbeda, seringkali dalam format yang berbeda.
Data lake memberi bisnis tempat untuk mengumpulkan catatan-catatan tersebut tanpa mengharuskan setiap sumber data untuk terlebih dahulu sesuai dengan struktur yang telah ditentukan. Fleksibilitas ini membuatnya berguna ketika pertanyaan-pertanyaan yang diajukan belum diketahui, ketika data mencakup format seperti audio atau log, atau ketika kumpulan data historis yang besar perlu disimpan untuk analisis.
Namun, menyimpan semuanya tidak sama dengan membuat semuanya bermanfaat. Tanpa katalogisasi, kontrol kualitas, aturan akses, dan kasus penggunaan yang jelas, data lake dapat menjadi silo lain.
Apa Itu Data Lake?
Data lake adalah lingkungan penyimpanan terpusat yang dirancang untuk menyimpan sejumlah besar data dalam bentuk aslinya atau mendekati aslinya. Alih-alih mengharuskan setiap dataset untuk mengikuti struktur tetap sebelum disimpan, data lake dapat menyimpan berbagai jenis informasi dan menerapkan struktur ketika data tersebut dibutuhkan untuk analisis.
Hal ini membuatnya cocok untuk data seperti:
- Data terstruktur: Tabel dari basis data, spreadsheet, transaksi, dan catatan lainnya yang diorganisasikan ke dalam bidang-bidang yang telah ditentukan.
- Data semi terstruktur: JSON, XML, peristiwa aplikasi, dan log yang berisi label atau kunci tetapi tidak mengikuti satu struktur relasional tetap.
- Data tidak terstruktur: Rekaman panggilan, dokumen, gambar, video, transkrip, dan konten lain yang tidak sesuai dengan baris dan kolom.
Perbedaan pentingnya adalah ketika data terstruktur.
Sistem relasional tradisional umumnya mendefinisikan model data sebelum menyimpan informasi. Data lake dapat menyimpan data sumber terlebih dahulu dan menentukan cara menginterpretasikan atau mentransformasikannya ketika seorang analis, aplikasi, atau proses pembelajaran mesin membutuhkannya.
Fleksibilitas tersebut mempermudah pengintegrasian sumber data baru ke dalam lingkungan. Namun, hal itu juga menciptakan tanggung jawab: seseorang tetap perlu mengetahui arti data tersebut, dari mana asalnya, apakah data tersebut dapat diandalkan, dan siapa yang diizinkan untuk menggunakannya.
Alur Kerja Data Lake
Data lake memindahkan data melalui beberapa tahapan yang saling terhubung, dari pengumpulan hingga analisis. Setiap tahapan memiliki tugas spesifik, dan tata kelola berjalan di seluruh proses.
- Kumpulkan data: Data berasal dari sistem CRM dan ERP, situs web, aplikasi seluler, perangkat IoT, platform pembayaran, dan sumber pihak ketiga.
- Masukkan data: Proses pemasukan data memindahkan data ke dalam lake melalui batch terjadwal atau aliran berkelanjutan, tergantung pada seberapa cepat data tersebut perlu tersedia.
- Simpan datanya: Lake menyimpan data dalam bentuk aslinya atau mendekati bentuk aslinya. Penyimpanan objek cloud umumnya digunakan karena dapat menangani volume besar dan berbagai format file.
- Olah data tersebut: Alur kerja analitik dan pembelajaran mesin membersihkan, menggabungkan, mengubah, atau menyusun data untuk pertanyaan atau kasus penggunaan tertentu.
- Gunakan data tersebut: Analis dapat melakukan kueri data melalui alat BI, sementara ilmuwan data dan aplikasi dapat menggunakannya untuk analitik, pembelajaran mesin, dan beban kerja lainnya.
- Kelola data: Kontrol akses, katalog, silsilah data, pemeriksaan kualitas, aturan retensi, dan langkah-langkah keamanan membantu menjaga agar data tetap akurat, mudah ditemukan, dan terlindungi dengan tepat.
Ide utamanya adalah bahwa penyimpanan dan interpretasi dipisahkanOleh karena itu, sumber data mentah yang sama dapat mendukung berbagai penggunaan analitis tanpa perlu mengubah data asli secara permanen untuk satu laporan tertentu.
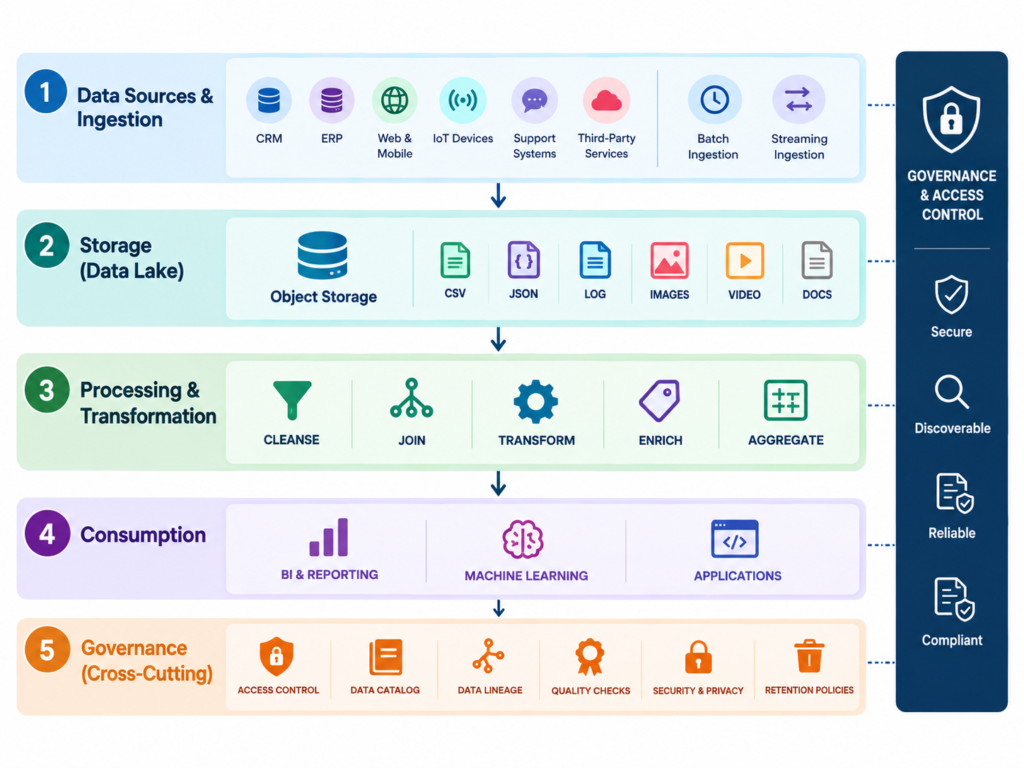
Komponen-Komponen Utama dari Sebuah Data Lake
Sebuah data lake yang berfungsi membutuhkan lebih dari sekadar wadah penyimpanan besar. Data harus masuk dengan andal, tetap mudah ditemukan, diproses secara efisien, dan sampai ke pengguna dalam bentuk yang benar-benar dapat mereka gunakan. Enam komponen di bawah ini mencakup arsitektur intinya.
1. Sumber data
Sumber-sumber tersebut menyediakan bahan mentah untuk danau tersebut.
Contoh umum termasuk:
- catatan CRM
- Transaksi ERP
- Acara di situs web
- Log aplikasi
- Telemetri IoT
- Sistem dukungan pelanggan
- Platform pemasaran
- Kumpulan data pihak ketiga
- Dokumen, audio, gambar, dan video
Nilai dari penambahan sumber data bergantung pada apa yang ingin dipelajari oleh bisnis darinya. Mengumpulkan setiap kejadian yang tersedia tanpa tujuan akan meningkatkan kebutuhan penyimpanan dan tata kelola tanpa harus meningkatkan analisis.
2. Penyerapan Data
Proses penyerapan data memindahkan data dari sistem sumber ke dalam danau data. Dua pendekatan umum adalah:
- Pengambilan sampel secara bertahap: Data ditransfer pada interval terjadwal. Ini sangat cocok untuk pelaporan dan kasus penggunaan di mana pembaruan setiap jam atau setiap hari sudah cukup.
- Pengambilan data secara streaming: Peristiwa ditransfer secara terus menerus atau dengan latensi yang sangat rendah. Hal ini lebih tepat digunakan ketika pengambilan keputusan bergantung pada peristiwa terkini, seperti pemantauan waktu nyata atau aplikasi berbasis peristiwa.
Streaming tidak otomatis lebih baik. Streaming memperkenalkan infrastruktur tambahan dan kompleksitas operasional, sehingga pertimbangan bisnis harus menentukan apakah latensi yang lebih rendah benar-benar bermanfaat.
3. Penyimpanan
Penyimpanan menyimpan data yang masuk dan metadata terkaitnya. Penyimpanan objek umum digunakan karena dapat menangani kumpulan data besar dan berbagai jenis file tanpa mengharuskan setiap file untuk sesuai dengan skema yang sama.
Namun, biaya penyimpanan hanyalah satu bagian dari aspek ekonomi. Pemrosesan, transfer data, keamanan, pemantauan, tata kelola, dan beban kerja kueri juga dapat berkontribusi secara signifikan terhadap total biaya pengoperasian data lake.
4. Memproses
Pemrosesan mengubah data yang tersimpan menjadi bentuk yang sesuai untuk penggunaan tertentu. Misalnya, sebuah bisnis mungkin:
- Hapus data duplikat
- Standarisasi stempel waktu
- Gabungkan ID pelanggan di berbagai sistem.
- Ekstrak sentimen dari percakapan dukungan pelanggan.
- Mengubah peristiwa menjadi fitur perilaku.
- Transaksi agregat
- Mempersiapkan data pelatihan untuk model pembelajaran mesin.
Sumber data mentah dapat tetap terjaga sementara transformasi ini dibuat untuk tujuan analisis tertentu.
5. Tata Kelola
Tata kelola menentukan apakah orang benar-benar dapat mempercayai dan menggunakan data dengan aman.
Hal ini dapat mencakup:
- Katalog data
- Catatan kepemilikan
- Garis keturunan data
- Pemeriksaan kualitas
- Kontrol akses
- Aturan privasi
- Kebijakan retensi
- Jalur audit
Hal ini sangat penting terutama ketika data di dalam data tersebut berisi informasi pelanggan. Menyimpan data secara terpusat tidak menghilangkan kewajiban privasi, keamanan, atau kepatuhan yang melekat pada data tersebut.
6. Konsumsi
Lapisan konsumsi adalah tempat data yang tersimpan menjadi bermanfaat. Pengguna yang berbeda dapat mengonsumsi informasi dasar yang sama melalui:
- Dasbor BI
- query SQL
- Aplikasi analitis
- Alur kerja pembelajaran mesin
- Notebook ilmu data
- Aplikasi operasional
Sebuah data lake hanya akan berhasil jika lapisan ini menghasilkan analisis atau tindakan yang bermanfaat. Volume data yang besar yang tersimpan bukanlah hasil akhir dengan sendirinya.
Danau Data vs Gudang Data
Data lake dan data warehouse memecahkan masalah yang terkait tetapi berbeda. Warehouse umumnya dirancang berdasarkan pertanyaan analitis yang terstruktur dan berulang, sementara data lake memberikan fleksibilitas yang lebih besar untuk data mentah, beragam, dan eksploratif.
| Atribut | Danau Data | Gudang data |
| Data diterima | Terstruktur, semi-terstruktur, tidak terstruktur | Terstruktur terutama |
| Status data | Seringkali disimpan dalam bentuk mentah. | Dibersihkan dan diubah |
| Ketika struktur diterapkan | Biasanya selama analisis atau transformasi | Sebelum atau selama pemuatan |
| Pengguna umum | Ilmuwan data, insinyur, analis | Analis, tim bisnis |
| Kekuatan tipikal | Eksplorasi dan data yang beragam | Pelaporan dan analisis yang konsisten |
| Performa kueri | Tergantung pada arsitektur dan beban kerja. | Biasanya dioptimalkan untuk kueri berulang. |
| Kasus penggunaan umum | AI, eksplorasi, data perilaku | BI, pelaporan keuangan, analisis operasional |
Perbedaan tersebut menjadi lebih jelas ketika melihat pertanyaan-pertanyaan yang dirancang untuk dijawab oleh masing-masing sistem.
Gudang sangat cocok untuk pertanyaan-pertanyaan seperti:
- Berapakah angka penjualan berdasarkan wilayah pada kuartal lalu?
- Kategori produk mana yang menghasilkan margin tertinggi?
- Bagaimana tingkat churn berubah selama setahun terakhir?
Pertanyaan-pertanyaan ini diketahui sebelumnya, sehingga data dapat dibersihkan dan diorganisir berdasarkan pertanyaan-pertanyaan tersebut.
Sebuah lake lebih bermanfaat ketika bisnis ingin mengeksplorasi informasi yang tidak sesuai dengan struktur yang telah ditentukan sebelumnya.
Sebagai contoh:
- Apakah percakapan dukungan pelanggan mengandung sinyal yang memprediksi pelanggan akan berhenti berlangganan?
- Apakah penggunaan produk memengaruhi perpanjangan kontrak?
- Urutan tindakan situs web mana yang terkait dengan konversi?
- Apakah rekaman panggilan dapat memberikan informasi yang berguna untuk model prediksi penjualan?
Oleh karena itu, banyak organisasi menggunakan keduanya. Gudang data mendukung pelaporan yang sudah mapan, sementara danau data menyediakan lingkungan yang lebih luas untuk eksplorasi, pembelajaran mesin, dan data yang beragam.
Catatan penting: Data lake adalah lingkungan data analitik. Ia dapat menyimpan dan memproses informasi pelanggan, tetapi tidak menggantikan fungsi operasional yang mengelola prospek, transaksi, kasus, kampanye, atau interaksi pelanggan – seperti halnya sistem yang mengelola prospek, transaksi, kasus, kampanye, atau interaksi pelanggan. CRM bisa.
Manfaat Danau Data
Alasan terkuat untuk membangun data lake bukanlah semata-mata karena banyaknya data yang dapat ditampungnya. Nilainya terletak pada kemampuannya menyimpan berbagai jenis informasi dan menganalisisnya untuk menjawab pertanyaan yang tidak dapat dijawab secara efisien oleh sistem operasional yang ada.
Meningkatkan Skala Tanpa Mendesain Ulang Setiap Sumber
Data lake dapat mengakomodasi volume data yang terus bertambah tanpa mengharuskan setiap dataset baru untuk sesuai dengan skema relasional yang sudah ada.
Hal itu berguna ketika suatu bisnis menambahkan:
- Aplikasi baru
- Produk baru
- Saluran pelanggan baru
- Bisnis yang diakuisisi
- Sumber data perilaku baru
Sumber data baru ini dapat diintegrasikan dan dikatalogkan tanpa perlu mendesain ulang setiap tabel analitik yang ada terlebih dahulu.
Dukungan untuk Berbagai Tipe Data
Banyak sinyal bisnis yang bermanfaat tidak datang dalam bentuk baris dan kolom yang rapi.
Sebuah danau dapat menampung:
- Rekaman panggilan
- Transkrip pendukung
- Gambar produk
- Documents
- Acara di situs web
- Log aplikasi
- Telemetri IoT
Sumber-sumber ini nantinya dapat diubah menjadi fitur atau kumpulan data untuk tujuan analisis tertentu.
Landasan Fleksibel untuk AI dan Pembelajaran Mesin
Proyek AI seringkali membutuhkan data historis dari berbagai sumber. Sebuah lake dapat menyediakan lingkungan pusat untuk menyimpan informasi tersebut dan mempersiapkannya untuk pengembangan model.
Namun, lebih banyak data tidak secara otomatis menghasilkan AI yang lebih baik.
Data tersebut masih perlu:
- Berkaitan dengan prediksi
- Dilabeli dengan benar di tempat yang diperlukan.
- Cukup konsisten untuk dianalisis
- Mewakili populasi yang dimodelkan
- Dikelola dengan baik
- Dapat diakses melalui alur kerja pemodelan.
Keunggulan danau adalah kemampuannya untuk menyimpan berbagai sinyal potensial sebelum bisnis mengetahui sinyal mana yang akan terbukti bermanfaat.
Mengurangi Silo Data Analitis
Sebuah danau dapat menyatukan informasi dari beberapa sistem ke dalam lingkungan analisis yang umum.
Sebagai contoh, peritel dapat menggabungkan:
Transaksi + perilaku situs web + keterlibatan pemasaran + dukungan pelanggan
alih-alih meminta empat sistem untuk empat laporan terpisah.
Hal itu tidak menghilangkan semua masalah integrasi, tetapi dapat mengurangi ekspor berulang dan rekonsiliasi manual untuk beban kerja analitis.
Jangan samakan kapasitas penyimpanan dengan kemudahan penggunaan: Sebuah danau data dapat berubah menjadi "rawa data" ketika kumpulan data didokumentasikan dengan buruk, sulit ditemukan, tidak dapat diandalkan, atau mahal untuk diakses. Oleh karena itu, tata kelola, katalogisasi, kontrol kualitas, dan kepemilikan merupakan bagian dari arsitektur, bukan sekadar pekerjaan pembersihan opsional.
Kasus Penggunaan Data Lake
Data lake menjadi berharga ketika suatu bisnis perlu menganalisis informasi yang terlalu beragam, terlalu besar, terlalu historis, atau terlalu tersebar sehingga sistem yang ada tidak mampu menanganinya secara efisien.
Analisis Lintas Sistem
Sebuah danau dapat menggabungkan informasi dari sistem yang dirancang untuk tujuan operasional yang berbeda.
Sebagai contoh, sebuah bisnis dapat menganalisis:
- Riwayat pembelian
- Aktivitas situs web
- Keterlibatan pemasaran
- Interaksi dukungan
- Penggunaan produk
dalam satu alur kerja analitis tunggal.
Hal ini dapat mengungkap hubungan yang sulit diidentifikasi ketika setiap sistem dianalisis secara independen.
Pembelajaran Mesin dan AI
Danau dapat menyediakan lingkungan sentral untuk mempersiapkan data historis untuk pembelajaran mesin.
Kemungkinan aplikasi meliputi:
- prediksi churn
- Peramalan permintaan
- Sistem rekomendasi
- Deteksi penipuan
- Pemodelan kecenderungan pelanggan
- Pemeliharaan prediktif
Danau tersebut tidak menciptakan model itu sendiri. Danau tersebut menyediakan penyimpanan dan akses ke data yang diperlukan untuk membangun, menguji, dan meningkatkan model.
Analisis Perilaku Pelanggan
Sistem CRM operasional biasanya menangkap informasi yang dibutuhkan untuk mengelola hubungan pelanggan. Sebuah danau dapat menyimpan aliran peristiwa perilaku yang lebih luas.
Ini dapat mencakup:
- Perjalanan di situs web
- Aktivitas pencarian
- Acara sesi
- Pengabaian kereta
- Penggunaan produk
- Interaksi email
- Aktivitas dukungan
Menganalisis peristiwa-peristiwa ini dari waktu ke waktu dapat membantu bisnis mengidentifikasi pola yang tidak terlihat dalam catatan CRM individual.
Konsolidasi Data Setelah Akuisisi
Akuisisi sering kali membuat bisnis memiliki beberapa sistem CRM, ERP, analitik, dan operasional. Data lake dapat menyediakan lingkungan analitik bersama tanpa mengharuskan setiap sistem lama untuk dimigrasikan segera. Hal ini dapat berguna ketika tujuan langsungnya adalah untuk menganalisis bisnis gabungan sementara konsolidasi sistem jangka panjang masih direncanakan.
Bagaimana Data Lake Mendukung CRM Berbasis AI
CRM berisi informasi yang dibutuhkan bisnis untuk mengelola hubungan pelanggan. Data lake dapat berisi riwayat perilaku pelanggan, penggunaan produk, aktivitas digital, dan interaksi yang jauh lebih luas.
Oleh karena itu, menghubungkan keduanya dapat memberikan sistem AI sinyal tambahan untuk dianalisis. Namun, lake data tidak secara otomatis meningkatkan model CRM. Data tersebut harus terlebih dahulu relevan, terhubung dengan pelanggan atau akun yang tepat, diatur, dan tersedia untuk pemodelan atau alur kerja operasional.
Tambahkan Konteks di Luar Catatan CRM
The Struktur basis data CRM Dapat berisi informasi kontak, riwayat transaksi, aktivitas, kasus, dan catatan hubungan lainnya.
Data lake dapat menambahkan informasi yang biasanya tidak disimpan sepenuhnya oleh CRM, seperti:
- Acara situs web terperinci
- Penggunaan produk
- Rekaman panggilan
- Log aplikasi
- Peristiwa perilaku historis
Secara bersama-sama, sumber-sumber ini dapat memberikan pandangan yang lebih luas tentang apa yang terjadi sebelum, selama, dan setelah interaksi pelanggan.
Berikan Sinyal yang Lebih Relevan pada Model Prediktif
Model AI prediktif dapat menggunakan pola historis untuk memperkirakan kemungkinan hasil.
Sebagai contoh, model prediksi pelanggan yang berhenti berlangganan berpotensi mempertimbangkan aktivitas dukungan pelanggan, penggunaan produk, keterlibatan, dan riwayat pembelian, alih-alih hanya mengandalkan satu sinyal saja.
Kata kuncinya adalah relevan. Menambahkan ribuan bidang yang tidak terkait dapat meningkatkan kompleksitas tanpa meningkatkan prediksi. AI yang baik bergantung pada sinyal yang bermanfaat, data yang bersih, pemodelan yang tepat, dan evaluasi berkelanjutan.
Meningkatkan Segmentasi Pelanggan
Model segmentasi pelanggan dapat menjadi lebih berfokus pada perilaku ketika tersedia peristiwa pelanggan tambahan.
Alih-alih mengelompokkan pelanggan hanya berdasarkan apa yang mereka beli, sebuah bisnis dapat membedakan antara pelanggan yang:
- Sering melihat-lihat tetapi jarang membeli.
- Lakukan pembelian secara teratur dan ikuti kampanye yang ada.
- Dulu sering menggunakan suatu produk, tetapi baru-baru ini mengurangi penggunaannya.
- Hubungi dukungan pelanggan berulang kali sebelum memperbarui.
Pola-pola ini dapat menghasilkan penargetan yang lebih bermanfaat daripada segmen demografis atau segmen yang hanya berdasarkan transaksi.
Berikan Input yang Lebih Baik ke dalam Otomatisasi CRM
kemampuan AI CRM Dapat menggunakan data pelanggan dan interaksi untuk mendukung rekomendasi, prediksi, dan alur kerja otomatis lainnya.
Lapisan analitik dan CRM masih memiliki tugas yang berbeda.
Data lake dapat membantu mempersiapkan dan menganalisis kumpulan data yang lebih luas. CRM adalah tempat wawasan yang dihasilkan menjadi operasional, seperti mengidentifikasi pelanggan yang membutuhkan perhatian atau merekomendasikan tindakan selanjutnya.
Langkah terakhir itu penting. Wawasan yang tetap berada di dalam lingkungan analitis tidak akan meningkatkan pengalaman pelanggan sampai seseorang atau sesuatu dapat menindaklanjutinya.
Sebelum membangun data lake: Periksa apakah masalah tersebut memang membutuhkannya. Jika bisnis Anda dapat menjawab pertanyaan pelaporan dan manajemen pelanggan dengan CRM, gudang data, platform BI yang sudah ada, atau integrasi langsung, data lake mungkin akan menambah pekerjaan penyimpanan, rekayasa, keamanan, dan tata kelola yang tidak perlu.
Menerapkan Data Lake dengan Baik
Proyek data lake sebaiknya dimulai dengan pertanyaan bisnis yang perlu dijawab, bukan dengan keputusan tentang berapa banyak penyimpanan yang perlu disediakan. Implementasi yang paling bermanfaat juga menetapkan tata kelola dan kepemilikan sejak awal, daripada memperlakukannya sebagai latihan pembersihan di kemudian hari.
Mulailah dengan Pertanyaan Spesifik
Tentukan kasus penggunaan pertama sebelum mengumpulkan data.
Sebagai contoh:
- Pelanggan mana yang paling mungkin berhenti berlangganan?
- Perilaku produk apa yang memprediksi perpanjangan kontrak?
- Interaksi kampanye mana yang memengaruhi konversi?
- Pola dukungan mana yang menunjukkan ketidakpuasan?
Pertanyaan yang jelas membantu menentukan sumber mana yang sebenarnya termasuk dalam versi pertama danau tersebut.
Data Katalog Dari Awal
Setiap dataset harus memiliki informasi dasar tentang:
- Isi di dalamnya
- Dari mana asalnya
- Siapa pemiliknya?
- Seberapa sering diperbarui
- Seberapa andalnya
- Siapa yang dapat mengaksesnya?
Tanpa informasi ini, kumpulan file yang terus bertambah menjadi sulit untuk diinterpretasikan.
Terapkan Keamanan dan Kontrol Akses
Data pelanggan dan karyawan mungkin berisi informasi yang dapat mengidentifikasi seseorang secara pribadi atau informasi sensitif lainnya.
Oleh karena itu, kebijakan akses harus menentukan:
- Siapa yang dapat mengakses setiap dataset?
- Bidang mana yang memerlukan perlindungan tambahan?
- Berapa lama informasi harus disimpan?
- Bagaimana penggunaan data diaudit
- Bagaimana informasi sensitif disembunyikan atau dibatasi
Kontrol tersebut harus diterapkan pada danau sebagai bagian dari lingkungan data yang lebih luas, bukan sebagai tambahan yang dipikirkan kemudian.
Prinsip yang sama berlaku untuk lingkungan CRM. Misalnya, Kontrol keamanan CRM Dirancang untuk membatasi akses ke catatan pelanggan dan bisnis sesuai dengan kebutuhan organisasi.
Pilih Mode Batch atau Streaming Sesuai Kebutuhan
Jangan memilih streaming hanya karena terdengar lebih canggih. Pengambilan data secara batch mungkin sudah cukup ketika bisnis menganalisis perubahan harian atau per jam. Streaming menjadi lebih berharga ketika keputusan bergantung pada peristiwa yang tiba dalam hitungan detik atau menit. Pilihan yang tepat bergantung pada konsekuensi bisnis dari latensi.
Mengukur Penggunaan dan Hasil Bisnis
Sebuah data lake sebaiknya dievaluasi berdasarkan hasil yang dicapai, bukan berdasarkan volume penyimpanan.
Langkah-langkah yang bermanfaat meliputi:
- Jumlah kasus penggunaan analitik aktif
- Penggunaan kueri atau kumpulan data
- Waktu yang dibutuhkan untuk mempersiapkan data
- Pengurangan rekonsiliasi manual
- Performa model
- Penghematan waktu pelaporan
- Dampak terhadap pendapatan atau retensi jika dapat diukur.
Sebuah danau data yang berisi petabyte data tetapi tidak mendukung pengambilan keputusan yang berarti bukanlah platform data yang sukses.
Bagaimana Vtiger Mengubah Data CRM Menjadi Tindakan
Data lake dan CRM memiliki fungsi yang berbeda. Data lake mendukung beban kerja analitik yang lebih luas, sementara CRM membantu tim mengelola informasi pelanggan, aktivitas penjualan, interaksi layanan, dan tindak lanjut. Vtiger berfokus pada mengubah data yang sudah tersedia di CRM menjadi keputusan yang bermanfaat. Vtiger Kalkulus AI Menggunakan data CRM dan interaksi pelanggan untuk memberikan wawasan dan rekomendasi prediktif. Fitur-fitur yang didukungnya meliputi penilaian prospek prediktif, peramalan penjualan, analisis percakapan, dan rekomendasi tindakan terbaik selanjutnya.
Pertanyaan yang sering diajukan
Q1. Apa itu data lake?
Data lake adalah lingkungan penyimpanan terpusat untuk sejumlah besar data terstruktur, semi-terstruktur, dan tidak terstruktur. Data lake dapat menyimpan data dalam bentuk aslinya dan menerapkan struktur di kemudian hari ketika informasi tersebut siap untuk dianalisis.
Q2. Apa saja manfaat dari data lake?
Data lake dapat mengakomodasi berbagai tipe data, menangani volume data yang besar, menyimpan informasi historis untuk analisis, dan menyediakan lingkungan bersama untuk data dari berbagai sistem. Manfaat ini bergantung pada tata kelola, keamanan, katalogisasi, dan kualitas data yang efektif.
Q3. Apa saja contoh kasus penggunaan data lake yang umum?
Kasus penggunaan umum meliputi analitik lintas sistem, pembelajaran mesin, analisis perilaku pelanggan, peramalan permintaan, sistem rekomendasi, dan konsolidasi data analitik dari berbagai unit bisnis atau sistem lama.
Q4. Apa perbedaan antara data lake dan data warehouse?
Data warehouse umumnya menyimpan data terstruktur dan siap pakai untuk kebutuhan analisis dan pelaporan yang telah ditetapkan. Data lake memberikan fleksibilitas yang lebih besar untuk data mentah dan beragam, sehingga berguna untuk eksplorasi, pembelajaran mesin, dan kasus penggunaan di mana struktur data yang dibutuhkan tidak diketahui sebelumnya.
Q5. Bagaimana data lake mendukung AI?
Data lake dapat menyediakan lingkungan terpusat untuk menyimpan dan mempersiapkan data historis dari berbagai sumber. Hal ini dapat memberikan tim pembelajaran mesin akses ke berbagai sinyal relevan yang lebih luas, meskipun lebih banyak data tidak secara otomatis menghasilkan model yang lebih baik.
Q6. Dapatkah data lake meningkatkan CRM?
Data lake dapat menyediakan data perilaku, produk, dan interaksi tambahan yang dapat memperkaya analitik CRM dan model AI. Data tersebut harus relevan, andal, terhubung dengan benar ke catatan pelanggan, diatur, dan tersedia untuk alur kerja CRM atau pemodelan sebelum dapat memberikan nilai.
Q7. Apa peran data lake dalam CRM berbasis AI?
Data lake dapat berfungsi sebagai lingkungan data analitik yang lebih luas, sementara CRM tetap menjadi sistem operasional untuk mengelola hubungan pelanggan. Wawasan yang dikembangkan dari kumpulan data yang lebih luas berpotensi mendukung prediksi CRM, segmentasi, rekomendasi, dan tindakan lain yang berorientasi pada pelanggan.
Q8. Apakah setiap bisnis membutuhkan data lake?
Tidak. Data lake paling berguna ketika suatu bisnis memiliki kumpulan data yang besar atau beragam yang tidak dapat dianalisis secara efisien oleh sistem yang ada, banyak sumber yang perlu diperiksa bersama, atau persyaratan pembelajaran mesin dan analitik yang membenarkan upaya rekayasa dan tata kelola tambahan.