Oggigiorno, le aziende raramente si basano su un'unica fonte di dati. Un cliente può navigare su un sito web, aprire un'e-mail, contattare l'assistenza clienti, utilizzare un prodotto, abbandonare un carrello e infine mettersi in contatto con il reparto vendite. Ogni interazione può lasciare una traccia in un sistema diverso, spesso in un formato differente.
Un data lake offre alle aziende un luogo in cui raccogliere questi dati senza che ogni fonte debba necessariamente conformarsi a una struttura predefinita. Questa flessibilità lo rende utile quando le domande non sono ancora note, quando i dati includono formati come audio o log, o quando è necessario conservare grandi set di dati storici per l'analisi.
Ma archiviare tutto non è la stessa cosa che rendere tutto utile. Senza catalogazione, controlli di qualità, regole di accesso e casi d'uso chiari, un data lake può diventare un altro silo.
Che cos'è un Data Lake?
Un data lake è un ambiente di archiviazione centralizzato progettato per contenere grandi volumi di dati nella loro forma originale o quasi originale. Invece di richiedere che ogni set di dati si conformi a una struttura fissa prima dell'archiviazione, può conservare diversi tipi di informazioni e applicare la struttura solo quando i dati sono necessari per l'analisi.
Ciò lo rende adatto a dati come:
- Dati strutturati: Tabelle provenienti da database, fogli di calcolo, transazioni e altri record, organizzate in campi definiti.
- Dati semistrutturati: File JSON, XML, eventi applicativi e log che contengono etichette o chiavi ma non seguono una struttura relazionale fissa.
- Dati non strutturati: Registrazioni di chiamate, documenti, immagini, video, trascrizioni e altri contenuti che non si adattano naturalmente a righe e colonne.
La distinzione importante è quando i dati sono strutturati.
Un sistema relazionale tradizionale definisce generalmente il modello dati prima di memorizzare le informazioni. Un data lake, invece, può memorizzare prima i dati di origine e determinare come interpretarli o trasformarli quando un analista, un'applicazione o un processo di apprendimento automatico ne ha bisogno.
Tale flessibilità facilita l'integrazione di nuove fonti di dati nell'ambiente. Tuttavia, comporta anche una responsabilità: qualcuno deve pur sempre sapere cosa significano i dati, da dove provengono, se sono affidabili e chi è autorizzato a utilizzarli.
Flusso di lavoro del Data Lake
Un data lake sposta i dati attraverso diverse fasi interconnesse, dalla raccolta all'analisi. Ogni fase ha una funzione specifica e la governance è applicata all'intero processo.
- Raccogli i dati: I dati provengono da sistemi CRM ed ERP, siti web, app per dispositivi mobili, dispositivi IoT, piattaforme di pagamento e fonti di terze parti.
- Acquisizione dei dati: Un processo di acquisizione sposta i dati nel data lake tramite batch programmati o flussi continui, a seconda della rapidità con cui devono essere disponibili.
- Memorizza i dati: Il data lake conserva i dati nella loro forma originale o quasi originale. L'archiviazione a oggetti nel cloud è comunemente utilizzata perché è in grado di gestire grandi volumi e diversi formati di file.
- Elaborare i dati: I flussi di lavoro analitici e di apprendimento automatico puliscono, combinano, trasformano o strutturano i dati per una domanda o un caso d'uso specifico.
- Utilizzare i dati: Gli analisti possono interrogare i dati tramite strumenti di business intelligence (BI), mentre gli scienziati dei dati e gli sviluppatori di applicazioni possono utilizzarli per analisi, apprendimento automatico e altri carichi di lavoro.
- Gestire i dati: I controlli di accesso, i cataloghi, la tracciabilità dei dati, i controlli di qualità, le regole di conservazione e le misure di sicurezza contribuiscono a mantenere i dati accurati, reperibili e adeguatamente protetti.
L'idea chiave è che L'archiviazione e l'interpretazione sono separateLa stessa fonte di dati grezzi può quindi supportare diversi utilizzi analitici senza che i dati originali vengano modificati in modo permanente per un particolare report.
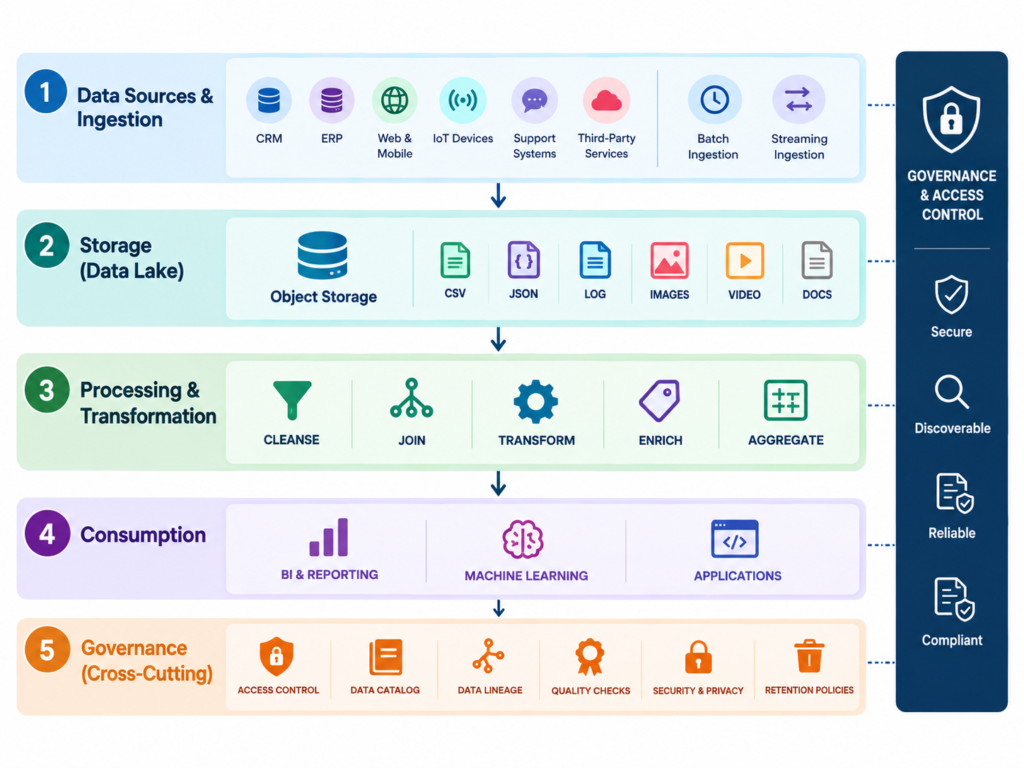
Componenti chiave di un Data Lake
Un data lake efficiente necessita di ben più di un semplice contenitore di grandi dimensioni. I dati devono essere inseriti in modo affidabile, rimanere facilmente reperibili, essere elaborati in modo efficiente e raggiungere gli utenti in un formato effettivamente utilizzabile. I sei componenti descritti di seguito costituiscono l'architettura di base.
1. Origine dei dati
Le sorgenti forniscono la materia prima per il lago.
Alcuni esempi includono:
- record CRM
- transazioni ERP
- Eventi sul sito web
- Log dell'applicazione
- Telemetria IoT
- Sistemi di assistenza clienti
- Piattaforme di marketing
- Set di dati di terze parti
- Documenti, audio, immagini e video
Il valore dell'aggiunta di una fonte dipende da ciò che l'azienda intende apprendere da essa. Raccogliere ogni evento disponibile senza uno scopo preciso aumenta i requisiti di archiviazione e di governance senza necessariamente migliorare l'analisi.
2. Inserimento dei dati
L'ingestione sposta i dati dai sistemi sorgente al lake. Due approcci comuni sono:
- Ingestione in batch: I dati vengono trasferiti a intervalli programmati. Questa soluzione è ideale per la creazione di report e per i casi d'uso in cui sono sufficienti aggiornamenti orari o giornalieri.
- Acquisizione in streaming: Gli eventi vengono trasferiti in modo continuo o con una latenza molto bassa. Questa soluzione è più appropriata quando le decisioni dipendono da eventi recenti, come nel caso del monitoraggio in tempo reale o delle applicazioni basate sugli eventi.
Lo streaming non è automaticamente migliore. Introduce infrastrutture e complessità operative aggiuntive, quindi è necessario valutare attentamente se la minore latenza sia effettivamente vantaggiosa.
3. Conservazione
Lo storage contiene i dati in entrata e i relativi metadati. Lo storage a oggetti è comune perché può gestire grandi insiemi di dati e diversi tipi di file senza che ogni file debba conformarsi allo stesso schema.
Tuttavia, il costo di archiviazione è solo una parte degli aspetti economici. L'elaborazione, il trasferimento dei dati, la sicurezza, il monitoraggio, la governance e i carichi di lavoro delle query possono contribuire in modo significativo al costo totale di gestione di un data lake.
4. in lavorazione
L'elaborazione converte i dati memorizzati in un formato adatto a un utilizzo specifico. Ad esempio, un'azienda potrebbe:
- Rimuovere i record duplicati
- Standardizzare i timestamp
- Unire gli ID cliente tra i sistemi
- Estrarre il sentiment dalle conversazioni di supporto
- Convertire gli eventi in caratteristiche comportamentali
- Transazioni aggregate
- Preparare i dati di addestramento per un modello di apprendimento automatico.
La materia prima grezza può rimanere conservata mentre queste trasformazioni vengono effettuate per specifici scopi analitici.
5. Governo
La governance determina se le persone possono effettivamente fidarsi dei dati e utilizzarli in modo sicuro.
Può includere:
- Cataloghi di dati
- Registri di proprietà
- Discendenza dei dati
- Controlli di qualità
- Controlli d'accesso
- Norme sulla privacy
- Politiche di conservazione
- audit trail
Ciò è particolarmente importante quando il data lake contiene informazioni sui clienti. L'archiviazione centralizzata dei dati non elimina gli obblighi in materia di privacy, sicurezza e conformità ad essi connessi.
6. Consumo
Il livello di consumo è dove i dati memorizzati diventano utili. Diversi utenti possono utilizzare le stesse informazioni sottostanti attraverso:
- Cruscotti BI
- query SQL
- Applicazioni analitiche
- Pipeline di apprendimento automatico
- Quaderni di data science
- Applicazioni operative
Un data lake ha successo solo quando questo livello conduce ad analisi o azioni utili. Grandi volumi di dati archiviati non sono di per sé un risultato.
Data Lake e Data Warehouse
I data lake e i data warehouse risolvono problemi correlati ma differenti. Un data warehouse è generalmente progettato attorno a domande analitiche strutturate e ripetibili, mentre un data lake offre maggiore flessibilità per dati grezzi, eterogenei ed esplorativi.
| Attributo | Lago di dati | magazzino dati |
| Dati accettati | Strutturato, semi-strutturato, non strutturato | Struttura principalmente |
| Stato dei dati | Spesso conservato allo stato grezzo | Pulito e trasformato |
| Quando la struttura viene applicata | Tipicamente durante l'analisi o la trasformazione | Prima o durante il caricamento |
| Utenti comuni | Data scientist, ingegneri, analisti | Analisti, team aziendali |
| Forza tipica | Esplorazione e dati variegati | Reportistica e analisi coerenti |
| Prestazioni di query | Dipende dall'architettura e dal carico di lavoro | Solitamente ottimizzato per query ricorrenti |
| Casi d'uso comuni | IA, esplorazione, dati comportamentali | Business Intelligence, reporting finanziario, analisi operativa |
La differenza diventa più chiara se si considerano le domande a cui ciascun sistema è progettato per rispondere.
Un magazzino è particolarmente adatto a rispondere a domande come:
- Quali sono state le vendite per regione nell'ultimo trimestre?
- Quale categoria di prodotti ha generato il margine più elevato?
- Come è cambiato il tasso di abbandono dei clienti nell'ultimo anno?
Queste domande sono note in anticipo, quindi i dati possono essere ripuliti e organizzati di conseguenza.
Un lago di informazioni è più utile quando l'azienda desidera esplorare informazioni che non si adattano perfettamente alle strutture predefinite.
Per esempio:
- Le conversazioni con l'assistenza clienti contengono segnali che predicono l'abbandono del servizio?
- L'utilizzo del prodotto influisce sul rinnovo?
- Quale sequenza di azioni sul sito web è associata alla conversione?
- Le registrazioni delle chiamate possono fornire informazioni utili per un modello di previsione delle vendite?
Molte organizzazioni, pertanto, li utilizzano entrambi. Il data warehouse supporta i sistemi di reporting consolidati, mentre il data lake offre un ambiente più ampio per l'esplorazione, l'apprendimento automatico e la gestione di dati di vario tipo.
Nota importante: Un data lake è un ambiente di dati analitico. Può archiviare ed elaborare le informazioni sui clienti, ma non sostituisce le funzioni operative che gestiscono lead, trattative, casi, campagne o interazioni con i clienti, come ad esempio CRM può.
Vantaggi di un Data Lake
Il motivo principale per costruire un data lake non risiede semplicemente nella quantità di dati che può contenere. Il suo valore deriva dalla capacità di conservare diverse tipologie di informazioni e di analizzarle per rispondere a domande a cui i sistemi operativi esistenti non sono in grado di dare una risposta efficiente.
Scalabilità senza riprogettare ogni fonte
Un data lake può gestire volumi di dati in continua crescita senza che ogni nuovo set di dati debba necessariamente adattarsi a uno schema relazionale esistente.
Ciò è utile quando un'azienda aggiunge:
- Una nuova applicazione
- Un nuovo prodotto
- Un nuovo canale clienti
- Un'azienda acquisita
- Una nuova fonte di dati comportamentali
La nuova fonte può essere acquisita e catalogata senza dover prima riprogettare ogni tabella analitica esistente.
Supporto per diversi tipi di dati
Molti segnali aziendali utili non si presentano sotto forma di righe e colonne ordinate.
Un lago può contenere:
- Chiama le registrazioni
- Trascrizioni di supporto
- Immagini del prodotto
- Documenti
- Eventi sul sito web
- Log dell'applicazione
- Telemetria IoT
Queste fonti possono essere successivamente trasformate in caratteristiche o set di dati per specifici scopi analitici.
Una base flessibile per l'intelligenza artificiale e l'apprendimento automatico.
I progetti di intelligenza artificiale spesso richiedono dati storici provenienti da diverse fonti. Un lago può fornire un ambiente centrale per conservare tali informazioni e prepararle per lo sviluppo del modello.
Ma una maggiore quantità di dati non si traduce automaticamente in un'intelligenza artificiale migliore.
I dati devono ancora essere:
- Rilevante per la previsione
- Etichettato correttamente dove richiesto
- Abbastanza coerente da poter essere analizzato
- Rappresentativo della popolazione oggetto della modellazione
- Governato correttamente
- Accessibile al flusso di lavoro di modellazione
Il vantaggio di un lago è che può preservare una gamma più ampia di potenziali segnali prima che l'azienda sappia quali si riveleranno utili.
Ridurre i silos di dati analitici
Un lago può convogliare informazioni provenienti da diversi sistemi in un ambiente analitico comune.
Ad esempio, un rivenditore potrebbe combinare:
Transazioni + comportamento sul sito web + coinvolgimento nel marketing + assistenza clienti
invece di chiedere a quattro sistemi quattro report separati.
Ciò non elimina tutti i problemi di integrazione, ma può ridurre le esportazioni ripetute e la riconciliazione manuale per i carichi di lavoro analitici.
Non confondere lo spazio di archiviazione con la funzionalità: Un lago di dati può trasformarsi in una "palude di dati" quando i set di dati sono scarsamente documentati, difficili da trovare, inaffidabili o costosi da interrogare. La governance, la catalogazione, i controlli di qualità e la proprietà sono quindi parte integrante dell'architettura, anziché un'attività di pulizia opzionale.
Casi d'uso del Data Lake
I data lake diventano preziosi quando un'azienda ha bisogno di analizzare informazioni troppo varie, troppo voluminose, troppo storiche o troppo distribuite perché i suoi sistemi esistenti possano gestirle in modo efficiente.
Analisi intersistemica
Un lago può combinare informazioni provenienti da sistemi progettati per scopi operativi differenti.
Ad esempio, un'azienda potrebbe analizzare:
- Cronologia degli acquisti
- Attività del sito web
- Coinvolgimento di marketing
- Interazioni di supporto
- utilizzo del prodotto
in un unico flusso di lavoro analitico.
Questo può rivelare relazioni difficili da identificare quando ogni sistema viene analizzato in modo indipendente.
Machine learning e AI
Un lago può fornire un ambiente ideale per preparare dati storici per l'apprendimento automatico.
Le possibili applicazioni includono:
- Previsione di Churn
- Previsione della domanda
- Sistemi di raccomandazione
- Intercettazione di una frode
- Modellazione della propensione del cliente
- Manutenzione predittiva
Il lago non crea il modello in sé. Fornisce lo spazio di archiviazione e l'accesso ai dati necessari per costruire, testare e migliorare i modelli.
Analisi del comportamento del cliente
I sistemi CRM operativi solitamente acquisiscono le informazioni necessarie per gestire le relazioni con i clienti. Un data lake, invece, può contenere un flusso più ampio di eventi comportamentali.
Questi possono includere:
- Percorsi sul sito web
- Attività di ricerca
- Eventi della sessione
- Abbandono del carrello
- utilizzo del prodotto
- Interazioni via e-mail
- Attività di supporto
Analizzare questi eventi nel tempo può aiutare le aziende a identificare modelli non visibili nei singoli record del CRM.
Consolidamento dei dati dopo le acquisizioni
Le acquisizioni spesso lasciano le aziende con diversi sistemi CRM, ERP, di analisi e operativi. Un data lake può fornire un ambiente analitico comune senza richiedere la migrazione immediata di tutti i sistemi legacy. Ciò può essere utile quando l'obiettivo immediato è analizzare l'azienda risultante dalla fusione, mentre si pianifica ancora il consolidamento dei sistemi a lungo termine.
Come i Data Lake supportano il CRM basato sull'intelligenza artificiale
Un CRM contiene le informazioni di cui un'azienda ha bisogno per gestire le relazioni con i clienti. Un data lake può contenere una cronologia molto più ampia del comportamento dei clienti, dell'utilizzo dei prodotti, dell'attività digitale e delle interazioni.
La connessione tra i due elementi può quindi fornire ai sistemi di intelligenza artificiale ulteriori segnali da analizzare. Tuttavia, il data lake non migliora automaticamente un modello CRM. I dati devono innanzitutto essere pertinenti, collegati al cliente o all'account corretto, gestiti e resi disponibili per la modellazione o il flusso di lavoro operativo.
Aggiungere contesto oltre al record CRM
Migliori Struttura del database CRM può contenere informazioni di contatto, cronologia delle transazioni, attività, casi e altri dati relativi ai rapporti con i clienti.
Un data lake può aggiungere informazioni che il CRM normalmente non conserva per intero, come ad esempio:
- Eventi dettagliati sul sito web
- utilizzo del prodotto
- Chiama le registrazioni
- Log dell'applicazione
- Eventi comportamentali storici
Nel loro insieme, queste fonti possono fornire una visione più ampia di ciò che è accaduto prima, durante e dopo un'interazione con un cliente.
Fornire ai modelli predittivi segnali più pertinenti
Modelli predittivi di intelligenza artificiale È possibile utilizzare modelli storici per stimare i risultati probabili.
Ad esempio, un modello di previsione dell'abbandono dei clienti potrebbe potenzialmente considerare l'attività di assistenza clienti, l'utilizzo del prodotto, il coinvolgimento e la cronologia degli acquisti, anziché basarsi su un singolo segnale.
La parola chiave è "pertinente". Aggiungere migliaia di campi non correlati può aumentare la complessità senza migliorare la previsione. Una buona IA dipende da segnali utili, dati puliti, modelli appropriati e valutazione continua.
Migliorare la segmentazione della clientela
modelli di segmentazione della clientela può diventare più focalizzato sul comportamento quando sono disponibili ulteriori eventi relativi ai clienti.
Anziché raggruppare i clienti solo in base a ciò che hanno acquistato, un'azienda potrebbe distinguere tra clienti che:
- Guardo spesso ma acquisto raramente.
- Acquista regolarmente e partecipa alle campagne
- Utilizzo un prodotto in modo intensivo, ma di recente ne ho ridotto l'uso.
- Contattare ripetutamente l'assistenza prima del rinnovo
Questi modelli possono portare a una segmentazione più efficace rispetto ai segmenti demografici o basati esclusivamente sulle transazioni.
Fornire input migliori all'automazione del CRM
Funzionalità AI CRM può utilizzare i dati dei clienti e delle interazioni per supportare raccomandazioni, previsioni e altri flussi di lavoro automatizzati.
Il livello analitico e il CRM hanno ancora funzioni diverse.
Il data lake può essere utile per preparare e analizzare set di dati più ampi. Il CRM è il sistema in cui le informazioni ricavate diventano operative, ad esempio identificando un cliente che necessita di attenzione o suggerendo un'azione successiva.
Quest'ultimo passaggio è fondamentale. Un'intuizione che rimane confinata in un ambiente analitico non migliora l'esperienza del cliente finché qualcuno o qualcosa non agisce di conseguenza.
Prima di costruire un data lake: Verifica se il problema richiede effettivamente un data lake. Se la tua azienda è in grado di rispondere alle domande relative alla reportistica e alla gestione dei clienti con un CRM, un data warehouse, una piattaforma di business intelligence o integrazioni dirette già esistenti, un data lake potrebbe introdurre attività superflue in termini di archiviazione, ingegneria, sicurezza e governance.
Implementazione di un pozzo di data lake
Un progetto di data lake dovrebbe iniziare con le domande aziendali a cui deve rispondere, non con una decisione su quanto spazio di archiviazione allocare. Le implementazioni più efficaci definiscono inoltre la governance e la responsabilità fin dalle prime fasi, anziché considerarle come un'attività di pulizia successiva.
Inizia con domande specifiche
Definisci i primi casi d'uso prima di raccogliere i dati.
Per esempio:
- Quali sono i clienti con maggiori probabilità di abbandonare il servizio?
- Quali comportamenti relativi al prodotto predicono il rinnovo dell'acquisto?
- Quali interazioni con la campagna influenzano le conversioni?
- Quali modelli di supporto indicano insoddisfazione?
Una domanda chiara aiuta a determinare quali fonti appartengono effettivamente alla prima versione del lago.
Dati del catalogo fin dall'inizio
Ogni set di dati dovrebbe contenere informazioni di base su:
- Cosa contiene
- Da dove viene
- Chi ne è il proprietario?
- Con quale frequenza viene aggiornato
- Quanto è affidabile
- Chi può accedervi
Senza queste informazioni, una raccolta sempre più ampia di file diventa difficile da interpretare.
Applicare controlli di sicurezza e di accesso
I dati dei clienti e dei dipendenti possono contenere informazioni personali o comunque sensibili.
Le politiche di accesso dovrebbero pertanto stabilire:
- Chi può accedere a ciascun set di dati
- Quali campi richiedono una protezione aggiuntiva?
- Per quanto tempo le informazioni devono essere conservate?
- Come viene verificato l'utilizzo dei dati
- Come vengono mascherate o limitate le informazioni sensibili
I controlli dovrebbero essere applicati al lago come parte integrante del più ampio contesto dei dati, e non come un ripensamento successivo.
Lo stesso principio si applica agli ambienti CRM. Ad esempio, controlli di sicurezza CRM sono progettati per limitare l'accesso ai dati dei clienti e aziendali in base alle esigenze organizzative.
Scegli tra elaborazione in batch o in streaming in base alle tue esigenze.
Non scegliete lo streaming solo perché sembra più avanzato. L'acquisizione batch può essere sufficiente quando l'azienda analizza variazioni giornaliere o orarie. Lo streaming diventa più prezioso quando le decisioni dipendono da eventi che arrivano entro pochi secondi o minuti. La scelta giusta dipende dalle conseguenze della latenza per l'azienda.
Misurare l'utilizzo e i risultati aziendali.
Un data lake dovrebbe essere valutato in base ai risultati ottenuti, non in base al volume di archiviazione.
Tra le misure utili si annoverano:
- Numero di casi d'uso analitici attivi
- Utilizzo di query o dataset
- Tempo necessario per preparare i dati
- Riduzione della riconciliazione manuale
- Performance del modello
- Tempo di reporting risparmiato
- Impatto sui ricavi o sulla fidelizzazione dei clienti, laddove misurabile.
Un lago di dati contenente petabyte di informazioni ma incapace di supportare decisioni significative non rappresenta una piattaforma dati efficace.
Come Vtiger trasforma i dati CRM in azioni
Un data lake e un CRM hanno funzioni diverse. Un data lake supporta carichi di lavoro analitici più ampi, mentre un CRM aiuta i team a gestire le informazioni sui clienti, le attività di vendita, le interazioni di assistenza e i follow-up. Vtiger si concentra sulla trasformazione dei dati già disponibili nel CRM in decisioni utili. Calcolo AI Utilizza i dati CRM e le interazioni con i clienti per fornire informazioni predittive e raccomandazioni. Supporta funzionalità quali l'assegnazione predittiva di punteggi ai lead, le previsioni di vendita, l'analisi delle conversazioni e le raccomandazioni sulle azioni successive più appropriate.
Domande frequenti (FAQ)
D1. Cos'è un data lake?
Un data lake è un ambiente di archiviazione centralizzato per grandi volumi di dati strutturati, semi-strutturati e non strutturati. Può conservare i dati nella loro forma originale e applicare la struttura in un secondo momento, quando le informazioni sono pronte per l'analisi.
D2. Quali sono i vantaggi di un data lake?
Un data lake può ospitare diversi tipi di dati, scalare fino a grandi volumi, conservare informazioni storiche per l'analisi e fornire un ambiente comune per i dati provenienti da più sistemi. Questi vantaggi dipendono da una governance, una sicurezza, una catalogazione e una qualità dei dati efficaci.
D3. Quali sono i casi d'uso più comuni dei data lake?
Tra i casi d'uso più comuni si annoverano l'analisi intersistemica, l'apprendimento automatico, l'analisi del comportamento dei clienti, la previsione della domanda, i sistemi di raccomandazione e il consolidamento dei dati analitici provenienti da diverse unità aziendali o sistemi legacy.
D4. Qual è la differenza tra un data lake e un data warehouse?
Un data warehouse in genere memorizza dati strutturati e preparati per esigenze di analisi e reporting predefinite. Un data lake offre maggiore flessibilità per dati grezzi e di varia natura, risultando utile per l'esplorazione, l'apprendimento automatico e i casi d'uso in cui la struttura dei dati richiesta non è nota in anticipo.
D5. In che modo un data lake supporta l'intelligenza artificiale?
Un data lake può fornire un ambiente centralizzato per conservare e preparare dati storici provenienti da diverse fonti. Ciò può consentire ai team di machine learning di accedere a una gamma più ampia di segnali rilevanti, sebbene una maggiore quantità di dati non si traduca automaticamente in un modello migliore.
D6. Un data lake può migliorare il CRM?
Un data lake può fornire dati aggiuntivi su comportamenti, prodotti e interazioni che possono arricchire le analisi CRM e i modelli di intelligenza artificiale. I dati devono essere pertinenti, affidabili, correttamente collegati ai record dei clienti, gestiti e resi disponibili al flusso di lavoro CRM o di modellazione prima di poter generare valore.
D7. Qual è il ruolo dei data lake nel CRM basato sull'intelligenza artificiale?
Un data lake può fungere da ambiente di dati analitici più ampio, mentre il CRM rimane il sistema operativo per la gestione delle relazioni con i clienti. Le informazioni ricavate da set di dati più ampi possono potenzialmente supportare le previsioni, la segmentazione, i consigli e altre azioni rivolte al cliente all'interno del CRM.
D8. Ogni azienda ha bisogno di un data lake?
No. Un data lake è più utile quando un'azienda dispone di set di dati ampi o eterogenei che i sistemi esistenti non sono in grado di analizzare in modo efficiente, di più fonti che devono essere esaminate congiuntamente, oppure di requisiti di machine learning e analisi che giustificano l'ulteriore impegno in termini di ingegneria e governance.