現代のビジネスでは、単一のデータソースだけで運営されることはほとんどありません。顧客はウェブサイトを閲覧したり、メールを開封したり、サポートに問い合わせたり、製品を使用したり、カートを放棄したり、最終的に営業担当者に連絡したりします。それぞれのやり取りは、異なるシステムに、多くの場合異なる形式で記録されます。
データレイクは、企業があらゆるデータソースを事前に定義された構造に適合させる必要なく、それらの記録を集約できる場所を提供します。この柔軟性により、まだ課題が明確でない場合、データに音声やログなどの形式が含まれる場合、または大規模な履歴データセットを分析のために保持する必要がある場合に、データレイクは役立ちます。
しかし、すべてを保存することと、すべてを有効活用することは同じではありません。カタログ化、品質管理、アクセスルール、明確なユースケースがなければ、データレイクは単なる別のサイロになってしまう可能性があります。
データレイクとは何ですか?
データレイクとは、大量のデータを元の形式またはそれに近い形式で保存するために設計された集中型ストレージ環境です。すべてのデータセットを保存前に固定構造に適合させる必要はなく、さまざまな種類の情報を保持し、分析に必要なときに構造を適用することができます。
そのため、以下のようなデータに適しています。
- 構造化データ: データベース、スプレッドシート、取引記録、その他の記録から抽出されたテーブルを、定義されたフィールドごとに整理したもの。
- 半構造化データ: ラベルやキーを含むが、固定された関係構造に従わないJSON、XML、アプリケーションイベント、ログ。
- 非構造化データ: 通話録音、文書、画像、動画、文字起こし、その他行と列に自然に収まらないコンテンツ。
重要な違いは データが構造化されている場合.
従来のリレーショナルシステムでは、情報を保存する前にデータモデルを定義するのが一般的です。一方、データレイクでは、まずソースデータを保存し、アナリスト、アプリケーション、または機械学習プロセスが必要としたときに、そのデータの解釈方法や変換方法を決定することができます。
その柔軟性によって、新しいデータソースを環境に取り込むことが容易になる。しかし同時に、責任も生じる。データの意味、出所、信頼性、そして誰がそのデータを使用できるのかを把握しておく必要があるからだ。
データレイクワークフロー
データレイクは、データの収集から分析まで、いくつかの相互接続された段階を経てデータを移動させます。各段階にはそれぞれ固有の役割があり、ガバナンスはプロセス全体にわたって適用されます。
- データを収集します。 データは、CRMおよびERPシステム、ウェブサイト、モバイルアプリ、IoTデバイス、決済プラットフォーム、およびサードパーティソースから取得されます。
- データを取り込む: 取り込みプロセスでは、データの利用可能性に応じて、スケジュールされたバッチ処理または連続ストリームによってデータをデータレイクに転送します。
- データを保存する: 湖には、データが元の形式またはそれに近い形で保存されます。クラウドオブジェクトストレージは、大容量のデータやさまざまなファイル形式に対応できるため、広く利用されています。
- データを処理する: 分析ワークフローと機械学習ワークフローは、特定の質問やユースケースに合わせて、データをクリーンアップ、結合、変換、または構造化します。
- データを使用する: アナリストはBIツールを通じてデータを照会でき、データサイエンティストやアプリケーション開発者は、分析、機械学習、その他のワークロードにデータを利用できる。
- データを管理する: アクセス制御、カタログ、データ系統、品質チェック、保持ルール、およびセキュリティ対策は、データの正確性、検索可能性、および適切な保護を維持するのに役立ちます。
重要な考え方は 保存と解釈は分離されているしたがって、同じ生データソースを、特定のレポートのために元のデータを恒久的に変更することなく、さまざまな分析用途に活用できる。
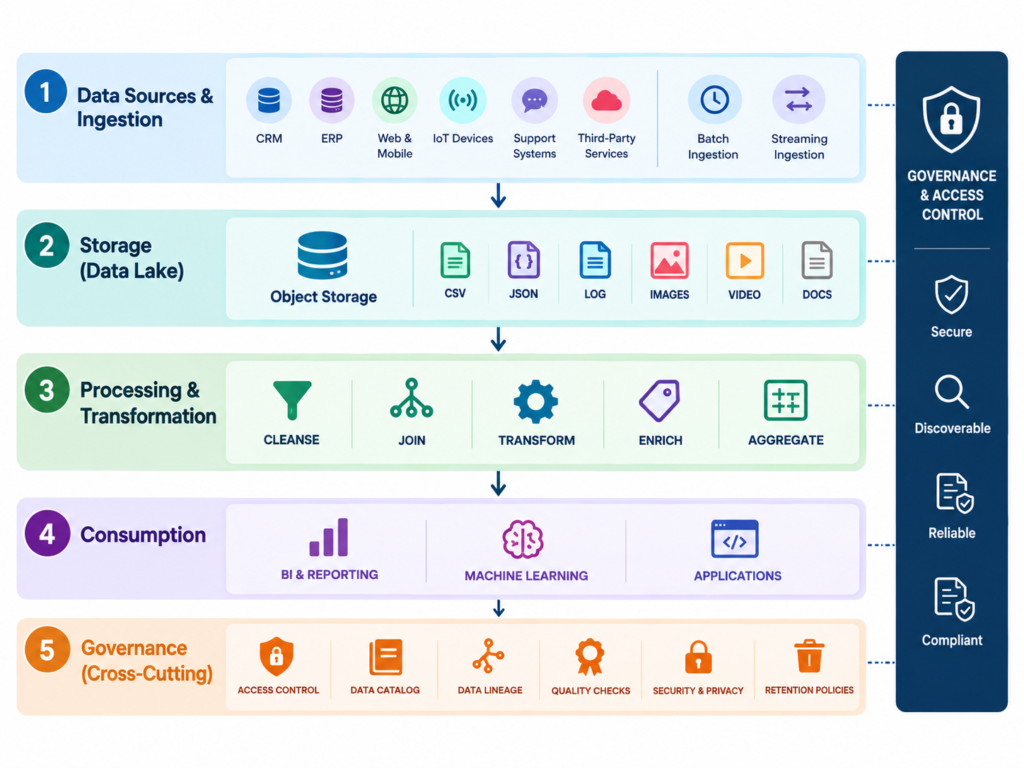
データレイクの主要構成要素
機能的なデータレイクには、単に大きなストレージバケット以上のものが必要です。データは確実に取り込まれ、検索可能であり、効率的に処理され、ユーザーが実際に利用できる形式で提供される必要があります。以下の6つのコンポーネントは、コアアーキテクチャを網羅しています。
1。 データソース
水源は湖の原材料を提供する。
一般的な例は次のとおりです。
- CRMレコード
- ERPトランザクション
- ウェブサイトのイベント
- アプリケーションログ
- IoTテレメトリ
- カスタマーサポートシステム
- マーケティングプラットフォーム
- 第三者データセット
- 文書、音声、画像、動画
データソースを追加する価値は、企業がそこから何を学びたいかによって決まります。目的もなく利用可能なすべてのイベントを収集すると、ストレージとガバナンスの要件が増加しますが、必ずしも分析が改善されるとは限りません。
2. データの取り込み
取り込みとは、ソースシステムからデータレイクへデータを移動させることです。一般的なアプローチは次の2つです。
- バッチ取り込み: データは決められた間隔で転送されます。これは、レポート作成や、1時間ごとまたは1日ごとの更新で十分なユースケースに適しています。
- ストリーミング取り込み: イベントは継続的に、または非常に低い遅延で転送されます。これは、リアルタイム監視やイベント駆動型アプリケーションなど、意思決定が直近のイベントに依存する場合に最適です。
ストリーミングは必ずしも優れているとは限りません。インフラストラクチャや運用上の複雑さが増すため、低遅延が実際に価値があるかどうかは、ビジネスケースに基づいて判断する必要があります。
3。 ストレージ
ストレージには、受信データとその関連メタデータが格納されます。オブジェクトストレージは、すべてのファイルが同じスキーマに準拠する必要なく、大規模なデータセットや複数のファイルタイプを処理できるため、広く利用されています。
しかし、ストレージコストは経済性の一部分にすぎません。処理、データ転送、セキュリティ、監視、ガバナンス、クエリのワークロードも、データレイクの運用コスト全体に大きく影響します。
4。 処理
処理とは、保存されたデータを特定の用途に適した形式に変換することです。例えば、企業は次のような処理を行う可能性があります。
- 重複レコードを削除する
- タイムスタンプを標準化する
- システム間で顧客IDを結合する
- サポート会話から感情を抽出する
- イベントを動作特性に変換する
- 集計取引
- 機械学習モデル用のトレーニングデータを準備する
これらの変換は特定の分析目的のために行われるが、元の原料はそのまま保存しておくことができる。
5.ガバナンス
ガバナンスは、人々が実際にデータを信頼し、安全に利用できるかどうかを決定づける。
これには以下が含まれます:
- データカタログ
- 所有記録
- データ系統
- 品質チェック
- アクセス制御
- プライバシー規則
- 保持ポリシー
- 監査証跡
これは、データに顧客情報が含まれている場合に特に重要です。データを一元的に保存しても、そのデータに付随するプライバシー、セキュリティ、または法令遵守に関する義務がなくなるわけではありません。
6。 消費
消費層は、保存されたデータが有用になる層です。異なるユーザーは、以下の方法で同じ基盤となる情報を利用する可能性があります。
- BIダッシュボード
- SQLクエリ
- 分析アプリケーション
- 機械学習パイプライン
- データサイエンスノートブック
- 運用アプリケーション
データレイクが成功するかどうかは、このレイヤーが有用な分析や行動につながるかどうかにかかっています。大量のデータが蓄積されること自体は、成功とは言えません。
データレイクとデータウェアハウス
データレイクとデータウェアハウスは、関連性はあるものの異なる問題を解決する。ウェアハウスは一般的に、構造化され、繰り返し可能な分析クエリを中心に設計されているのに対し、データレイクは、生データ、多様なデータ、探索的データに対してより高い柔軟性を提供する。
| 属性 | データレイク | データウェアハウス |
| データが受け入れられました | 構造化、半構造化、非構造化 | 主に構造化された |
| データ状態 | 多くの場合、生の形で保存される | 清掃され、生まれ変わった |
| 構造を適用すると | 通常、分析または変換中に | 積み込み前または積み込み中 |
| 一般ユーザー | データサイエンティスト、エンジニア、アナリスト | アナリスト、ビジネスチーム |
| 標準強度 | 探査と多様なデータ | 一貫性のあるレポートと分析 |
| クエリのパフォーマンス | アーキテクチャとワークロードによって異なります | 通常は繰り返しクエリに最適化されています |
| 一般的な使用例 | AI、探査、行動データ | ビジネスインテリジェンス、財務報告、業務分析 |
それぞれのシステムがどのような問いに答えるように設計されているかを見ていくと、その違いはより明確になる。
倉庫は次のような質問に適しています。
- 前四半期の地域別売上高はどのくらいでしたか?
- どの製品カテゴリーが最も高い利益率を生み出したか?
- 過去1年間で顧客離脱率はどのように変化しましたか?
これらの質問は事前に分かっているので、それらに基づいてデータを整理・分析することができる。
企業が、あらかじめ定義された構造にうまく収まらない情報を探索したい場合、レイクはより有用となる。
具体的な例を挙げますと、以下の通りです。
- サポート担当者との会話には、顧客離脱を予測する兆候が含まれているか?
- 製品の使用状況は更新時期に影響しますか?
- ウェブサイト上のどの操作シーケンスがコンバージョンに関連していますか?
- 通話録音は、売上予測モデルに役立つ情報を提供できるだろうか?
そのため、多くの組織は両方を利用しています。データウェアハウスは既存のレポート作成をサポートする一方、データレイクは探索、機械学習、多様なデータのためのより広範な環境を提供します。
重要な注意: データレイクは分析データ環境です。顧客情報を保存および処理できますが、リード、取引、ケース、キャンペーン、顧客とのやり取りなどを管理する運用機能を置き換えるものではありません。 CRM できる。
データレイクの利点
データレイクを構築する最大の理由は、単にどれだけのデータを保持できるかということだけではありません。その価値は、様々な種類の情報を保持し、既存の運用システムでは効率的に答えられない疑問に答えるために、それらの情報を分析することにあります。
すべてのソースを再設計することなく拡張する
データレイクは、増え続けるデータ量に対応でき、新しいデータセットごとに既存のリレーショナルスキーマに適合させる必要がない。
これは、企業が以下の機能を追加する際に役立ちます。
- 新しいアプリケーション
- 新製品
- 新しい顧客チャネル
- 買収された事業
- 行動データの新たな情報源
新しいデータソースは、既存の分析テーブルをすべて再設計することなく、取り込んでカタログ化することができます。
さまざまなデータ型への対応
多くの有益なビジネスシグナルは、整然とした行と列の形で現れるわけではない。
湖は以下のものを保持できる。
- 通話録音
- サポートトランスクリプト
- 商品画像
- ドキュメント
- ウェブサイトのイベント
- アプリケーションログ
- IoTテレメトリ
これらの情報源は、後々、特定の分析目的のために特徴量やデータセットに変換することができる。
AIと機械学習のための柔軟な基盤
AIプロジェクトでは、多くの場合、複数の情報源からの履歴データが必要となります。データレイクは、そうした情報を保持し、モデル開発のために準備するための中心的な環境を提供することができます。
しかし、データ量が増えたからといって、必ずしもより優れたAIが生まれるわけではない。
データはまだ以下の条件を満たす必要があります。
- 予測に関連する
- 必要な箇所に正しくラベルを貼付する
- 分析するのに十分な一貫性がある
- モデル化対象となる人口を代表するもの
- 適切に統治されている
- モデリングワークフローにアクセス可能
湖の利点は、企業がどの信号が有用であるかを判断する前に、より幅広い潜在的な信号を保存できる点にある。
分析データのサイロを削減する
湖は、複数のシステムからの情報を共通の分析環境に集約することができる。
例えば、小売業者は以下のようなものを組み合わせることができます。
取引 + ウェブサイトの行動 + マーケティングエンゲージメント + カスタマーサポート
4つのシステムにそれぞれ別のレポートを依頼するのではなく。
これはすべての統合問題を解消するわけではありませんが、分析ワークロードにおける繰り返しのエクスポートや手動による照合作業を削減することができます。
ストレージ容量と使いやすさを混同しないでください。 データセットのドキュメントが不十分だったり、見つけにくかったり、信頼性が低かったり、クエリにコストがかかったりすると、データ湖は「データ沼」と化してしまう可能性があります。そのため、ガバナンス、カタログ作成、品質管理、所有権は、オプションのクリーンアップ作業ではなく、アーキテクチャの一部として組み込まれています。
データレイクのユースケース
データレイクは、企業が既存システムでは効率的に処理できないほど多様、大規模、長期的、あるいは分散した情報を分析する必要がある場合に、その価値を発揮します。
クロスシステム分析
湖は、異なる運用目的のために設計されたシステムからの情報を統合することができる。
例えば、企業は以下のような分析を行うことができる。
- 購入履歴
- ウェブサイトの活動
- マーケティングエンゲージメント
- サポートインタラクション
- 製品の使用
単一の分析ワークフロー内で。
これにより、各システムを個別に分析した場合には特定しにくい関係性が明らかになる可能性がある。
機械学習とAI
湖は、機械学習のための過去データを準備する中心的な環境を提供できる。
考えられる用途としては、次のようなものがあります。
- チャーン予測
- 需要予測
- レコメンデーションシステム
- 不正検出
- 顧客購買意欲モデリング
- 予知保全
湖自体がモデルを作成するわけではありません。湖は、モデルの構築、テスト、および改善に必要なデータの保存とアクセスを提供します。
顧客行動分析
運用型のCRMシステムは通常、顧客関係の管理に必要な情報を収集します。一方、湖はより広範な行動イベントの流れを保持することができます。
これらには、
- ウェブサイトの旅
- 検索アクティビティ
- セッションイベント
- カートの放棄
- 製品の使用
- メールでのやり取り
- 支援活動
これらの事象を時系列で分析することで、企業は個々のCRM記録では見えないパターンを特定することができる。
買収後のデータ統合
企業買収によって、企業は複数のCRM、ERP、分析システム、運用システムを抱えることになる場合が多い。データレイクを活用すれば、既存システムをすべて即座に移行することなく、共通の分析環境を構築できる。これは、長期的なシステム統合計画を策定する一方で、統合後の事業を分析することが当面の目的である場合に特に有効である。
データレイクがAIを活用したCRMをどのようにサポートするか
CRMには、企業が顧客関係を管理するために必要な情報が含まれています。データレイクには、顧客の行動、製品の使用状況、デジタル活動、およびやり取りに関する、より広範な履歴を格納できます。
したがって、両者を連携させることで、AIシステムは分析対象となる追加のシグナルを得ることができる。しかし、データレイクが自動的にCRMモデルを改善するわけではない。まず、データは関連性があり、適切な顧客またはアカウントに紐づけられ、適切に管理され、モデリングまたは運用ワークフローで利用可能でなければならない。
CRMレコードを超えたコンテキストを追加する
その CRMデータベース構造 連絡先情報、取引履歴、活動内容、事例、その他の関係記録が含まれている場合があります。
データレイクは、CRMが通常完全には保持しない情報を追加できます。例えば、次のような情報です。
- ウェブサイトのイベント詳細
- 製品の使用
- 通話録音
- アプリケーションログ
- 歴史的な行動イベント
これらの情報源を組み合わせることで、顧客とのやり取りの前、最中、後に何が起こったのかをより包括的に把握することができる。
予測モデルに、より関連性の高いシグナルを与える
予測型AIモデル 過去のパターンを利用して、起こりうる結果を予測することができる。
例えば、顧客離脱予測モデルは、単一のシグナルに頼るのではなく、顧客サポート活動、製品使用状況、エンゲージメント、購入履歴などを考慮に入れる可能性がある。
重要なのは「関連性」という言葉です。無関係なフィールドを何千も追加しても、予測精度が向上することなく複雑さが増すだけです。優れたAIは、有用なシグナル、クリーンなデータ、適切なモデリング、そして継続的な評価に依存します。
顧客セグメンテーションの改善
顧客セグメンテーションモデル 顧客イベントが追加されると、より行動に焦点を当てた分析が可能になる。
顧客を購入した商品だけで分類するのではなく、企業は次のような顧客を区別するかもしれない。
- 頻繁に閲覧するが、購入することはほとんどない
- 定期的に購入し、キャンペーンに参加しましょう。
- 以前はよく使っていたが、最近は使用量を減らした。
- 更新前にサポートに繰り返し連絡してください
これらのパターンは、人口統計情報や取引履歴のみに基づくセグメントよりも、より効果的なターゲティングにつながる可能性がある。
CRM自動化に、より質の高い入力データを取り入れる
AI CRM機能 顧客データやインタラクションデータを利用して、推奨事項、予測、その他の自動化されたワークフローをサポートできます。
分析レイヤーとCRMは、依然として異なる役割を担っている。
データレイクは、より広範なデータセットの準備と分析に役立ちます。CRMは、得られた知見を実務に活用する場であり、例えば、注意が必要な顧客を特定したり、次の行動を推奨したりするのに役立ちます。
その最後のステップが重要なのです。分析環境の中に留まったままの洞察は、誰か、あるいは何かがそれに基づいて行動を起こさない限り、顧客体験の向上には繋がりません。
データレイクを構築する前に: 問題解決のために本当にデータレイクが必要かどうかを確認してください。既存のCRM、データウェアハウス、BIプラットフォーム、または直接統合によって、レポート作成や顧客管理に関する疑問に答えられるのであれば、データレイクを導入すると、不要なストレージ、エンジニアリング、セキュリティ、ガバナンス作業が発生する可能性があります。
データレイクをうまく実装する
データレイクプロジェクトは、ストレージ容量の決定から始めるのではなく、解決すべきビジネス上の課題を明確にすることから始めるべきです。また、最も効果的な実装では、ガバナンスと所有権を後回しにするのではなく、早い段階で確立します。
具体的な質問から始めましょう
データ収集の前に、最初のユースケースを定義してください。
具体的な例を挙げますと、以下の通りです。
- どの顧客が解約する可能性が最も高いか?
- どのような製品行動が更新を予測するのか?
- どのキャンペーンインタラクションがコンバージョンに影響を与えるか?
- どのような支持パターンが不満を示しているか?
明確な質問は、どの情報源が実際に湖の最初のバージョンに属するのかを判断するのに役立ちます。
カタログデータ(最初から)
すべてのデータセットには、以下の基本情報が含まれている必要があります。
- 内容
- どこから来たのか
- 誰が所有しているのか
- 更新頻度
- どれほど信頼できるか
- 誰がアクセスできるか
この情報がなければ、増え続けるファイルの解釈は困難になる。
セキュリティとアクセス制御を適用する
顧客データおよび従業員データには、個人を特定できる情報、またはその他の機密情報が含まれている可能性があります。
したがって、アクセスポリシーでは以下を定めるべきである。
- 各データセットにアクセスできるのは誰ですか?
- どの分野に追加の保護が必要ですか?
- 情報はどのくらいの期間保持すべきか
- データ使用状況の監査方法
- 機密情報がどのように隠蔽または制限されるか
これらの規制は、後付けではなく、より広範なデータ環境の一部として湖に適用されるべきである。
CRM環境にも同様の原則が適用されます。例えば、 CRMセキュリティ管理 組織の要件に従って、顧客記録および業務記録へのアクセスを制限するように設計されています。
必要に応じてバッチ処理またはストリーミング処理を選択してください。
ストリーミングの方が高度に聞こえるからといって、安易に選択してはいけません。ビジネスが日単位または時間単位の変化を分析する場合は、バッチ処理で十分な場合もあります。ストリーミングの価値が高まるのは、意思決定が数秒または数分以内に到着するイベントに依存する場合です。適切な選択は、遅延がビジネスに及ぼす影響によって決まります。
利用状況とビジネス成果を測定する
データレイクは、ストレージ容量ではなく、成果に基づいて評価されるべきである。
有効な対策としては、以下のようなものがあります。
- アクティブな分析ユースケースの数
- クエリまたはデータセットの使用状況
- データの準備に必要な時間
- 手作業による調整の削減
- モデルのパフォーマンス
- 報告時間の短縮
- 収益または顧客維持率への影響(測定可能な場合)
ペタバイト規模のデータが格納されていても、有意義な意思決定を支援できないデータレイクは、成功したデータプラットフォームとは言えない。
VtigerがCRMデータをアクションに変える方法
データレイクとCRMは役割が異なります。データレイクはより広範な分析ワークロードをサポートする一方、CRMはチームが顧客情報、販売活動、サービスインタラクション、フォローアップを管理するのに役立ちます。Vtigerは、CRMに既に存在するデータを有用な意思決定に変換することに重点を置いています。Vtigerの 微積分AI CRMデータと顧客とのやり取りを活用して、予測的な洞察と推奨事項を提供します。予測リードスコアリング、売上予測、会話分析、次善策の推奨などの機能をサポートします。
よくある質問(FAQ)
Q1. データレイクとは何ですか?
データレイクとは、構造化データ、半構造化データ、非構造化データといった大量のデータを一元的に保存する環境です。データを元の形式で保持し、分析のために情報が準備された時点で構造化することができます。
Q2. データレイクの利点は何ですか?
データレイクは、多様なデータタイプに対応し、大容量データにも対応でき、分析用の履歴情報を保持し、複数のシステムからのデータを共通の環境で管理できます。これらのメリットは、効果的なガバナンス、セキュリティ、カタログ作成、およびデータ品質に依存します。
Q3. データレイクの一般的なユースケースにはどのようなものがありますか?
一般的なユースケースとしては、システム間分析、機械学習、顧客行動分析、需要予測、レコメンデーションシステム、複数の事業部門や既存システムからの分析データの統合などが挙げられます。
Q4. データレイクとデータウェアハウスの違いは何ですか?
データウェアハウスは一般的に、確立された分析およびレポート作成ニーズに対応するために構造化され、準備されたデータを格納する。データレイクは、生データや多様なデータに対してより高い柔軟性を提供するため、探索、機械学習、および必要なデータ構造が事前に不明なユースケースに役立つ。
Q5. データレイクはどのようにAIをサポートしますか?
データレイクは、複数のソースからの履歴データを保持および準備するための中央環境を提供します。これにより、機械学習チームはより幅広い関連シグナルにアクセスできるようになりますが、データ量が増えたからといって必ずしもモデルが優れているとは限りません。
Q6. データレイクはCRMを改善できますか?
データレイクは、CRM分析やAIモデルを強化する可能性のある、行動データ、製品データ、インタラクションデータなどの追加情報を提供できます。ただし、データが価値を発揮するためには、関連性があり、信頼性が高く、顧客レコードに適切に接続され、管理され、CRMまたはモデリングワークフローで利用可能である必要があります。
Q7. AIを活用したCRMにおいて、データレイクはどのような役割を果たしますか?
データレイクはより広範な分析データ環境として機能し、CRMは顧客関係を管理するための運用システムとしての役割を担います。より広範なデータセットから得られた知見は、CRMの予測、セグメンテーション、レコメンデーション、その他の顧客対応活動を支援する可能性を秘めています。
Q8. すべての企業にデータレイクは必要ですか?
いいえ。データレイクが最も役立つのは、企業が既存のシステムでは効率的に分析できない大規模または多様なデータセットを保有している場合、複数の情報源をまとめて分析する必要がある場合、あるいは追加のエンジニアリングとガバナンスの労力を正当化する機械学習や分析の要件がある場合です。