Bedrijven draaien tegenwoordig zelden nog op één enkele databron. Een klant kan een website bezoeken, een e-mail openen, contact opnemen met de klantenservice, een product gebruiken, een winkelwagentje verlaten en uiteindelijk contact opnemen met de verkoopafdeling. Elke interactie kan een spoor achterlaten in een ander systeem, vaak in een ander formaat.
Een data lake biedt bedrijven een plek om die gegevens samen te brengen zonder dat elke bron eerst in een vooraf gedefinieerde structuur hoeft te passen. Die flexibiliteit is nuttig wanneer de onderzoeksvragen nog niet bekend zijn, wanneer gegevens formaten zoals audio of logbestanden bevatten, of wanneer grote historische datasets bewaard moeten worden voor analyse.
Maar alles opslaan is niet hetzelfde als alles nuttig maken. Zonder catalogisering, kwaliteitscontroles, toegangsregels en duidelijke gebruiksscenario's kan een data lake een nieuwe, geïsoleerde opslagplaats worden.
Wat is een datameer?
Een data lake is een gecentraliseerde opslagomgeving die is ontworpen om grote hoeveelheden data in hun oorspronkelijke of bijna oorspronkelijke vorm op te slaan. In plaats van te eisen dat elke dataset aan een vaste structuur voldoet voordat deze wordt opgeslagen, kan een data lake verschillende soorten informatie bevatten en de structuur ervan toepassen wanneer die data nodig is voor analyse.
Daardoor is het geschikt voor gegevens zoals:
- Gestructureerde gegevens: Tabellen uit databases, spreadsheets, transacties en andere gegevens, georganiseerd in gedefinieerde velden.
- Semi-gestructureerde data: JSON, XML, applicatiegebeurtenissen en logbestanden die labels of sleutels bevatten, maar geen vaste relationele structuur volgen.
- Ongestructureerde gegevens: Gespreksopnames, documenten, afbeeldingen, video's, transcripten en andere inhoud die niet vanzelfsprekend in rijen en kolommen past.
Het belangrijke onderscheid is wanneer de gegevens gestructureerd zijn.
Een traditioneel relationeel systeem definieert doorgaans het datamodel voordat de informatie wordt opgeslagen. Een data lake kan de brongegevens eerst opslaan en bepalen hoe deze moeten worden geïnterpreteerd of getransformeerd wanneer een analist, applicatie of machine learning-proces dit nodig heeft.
Die flexibiliteit maakt het gemakkelijker om nieuwe databronnen in de omgeving te integreren. Het brengt echter ook een verantwoordelijkheid met zich mee: iemand moet nog steeds weten wat de data betekenen, waar ze vandaan komen, of ze betrouwbaar zijn en wie ze mag gebruiken.
Data Lake-workflow
Een data lake verplaatst data door een aantal onderling verbonden fasen, van verzameling tot analyse. Elke fase heeft een specifieke taak en er is sprake van governance gedurende het hele proces.
- Verzamel de gegevens: De gegevens zijn afkomstig van CRM- en ERP-systemen, websites, mobiele apps, IoT-apparaten, betaalplatformen en externe bronnen.
- Verwerk de gegevens: Een ingestieproces verplaatst gegevens naar het data lake via geplande batches of continue streams, afhankelijk van hoe snel de gegevens beschikbaar moeten zijn.
- Sla de gegevens op: Een data lake bewaart de data in de oorspronkelijke of bijna oorspronkelijke vorm. Cloudobjectopslag wordt veel gebruikt omdat het grote volumes en verschillende bestandsformaten aankan.
- Verwerk de gegevens: Analytische en machine learning-workflows schonen, combineren, transformeren of structureren de data voor een specifieke vraag of toepassing.
- Gebruik de gegevens: Analisten kunnen de gegevens opvragen via BI-tools, terwijl datawetenschappers en applicaties ze kunnen gebruiken voor analyses, machine learning en andere taken.
- Beheer de gegevens: Toegangscontrole, catalogi, dataherkomst, kwaliteitscontroles, bewaarregels en beveiligingsmaatregelen helpen de gegevens accuraat, vindbaar en adequaat beschermd te houden.
Het kernidee is dat Opslag en interpretatie zijn gescheiden.Dezelfde ruwe bron kan dus verschillende analytische toepassingen ondersteunen zonder dat de oorspronkelijke gegevens permanent hoeven te worden aangepast voor één specifiek rapport.
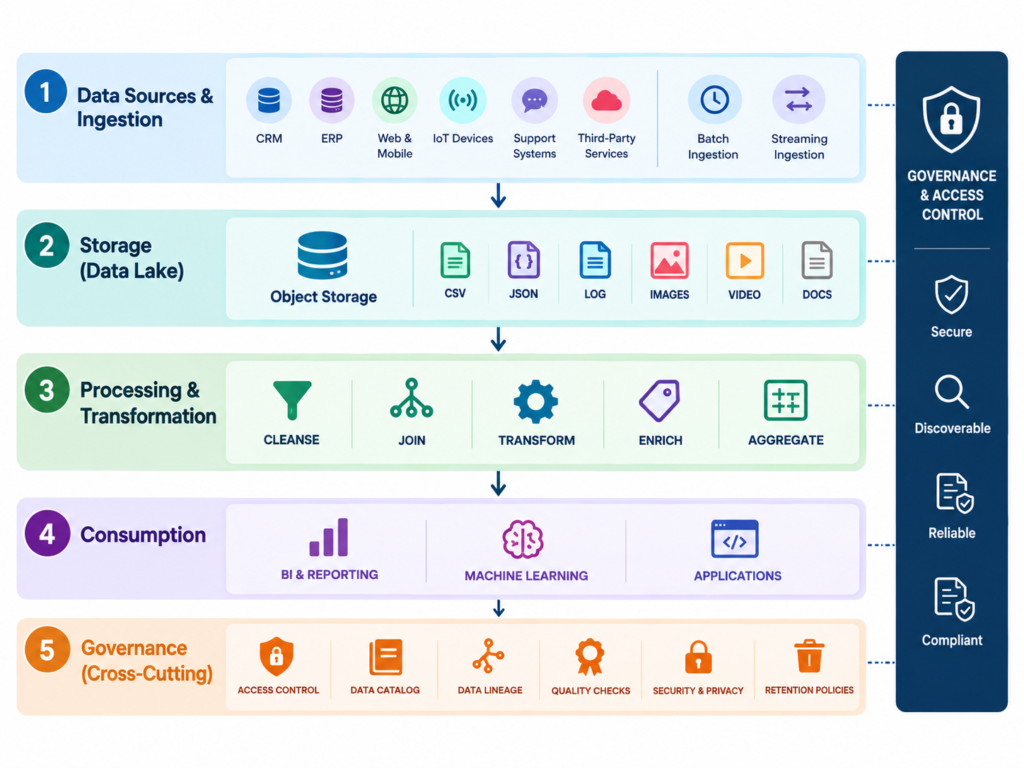
Belangrijkste componenten van een data lake
Een functionerend data lake heeft meer nodig dan alleen een grote opslagcontainer. Data moet betrouwbaar worden aangeleverd, vindbaar blijven, efficiënt worden verwerkt en gebruikers bereiken in een vorm die ze daadwerkelijk kunnen gebruiken. De zes onderstaande componenten vormen de kern van de architectuur.
1. Data bronnen
Bronnen leveren de grondstof voor het meer.
Bekende voorbeelden zijn:
- CRM-records
- ERP-transacties
- Website-evenementen
- Applicatielogboeken
- IoT-telemetrie
- Klantenondersteuningssystemen
- Marketingplatformen
- Gegevenssets van derden
- Documenten, audio, afbeeldingen en video
De waarde van het toevoegen van een bron hangt af van wat het bedrijf ermee wil leren. Het zonder doel verzamelen van elke beschikbare gebeurtenis verhoogt de opslag- en beheervereisten zonder dat dit de analyse noodzakelijkerwijs verbetert.
2. Gegevensopname
Bij data-invoer worden gegevens van bronsystemen naar het data lake verplaatst. Twee veelgebruikte methoden zijn:
- Batchverwerking: Gegevens worden met vaste tussenpozen overgedragen. Dit werkt goed voor rapportages en toepassingen waarbij updates per uur of per dag voldoende zijn.
- Streaming-opname: Gebeurtenissen worden continu of met een zeer lage latentie overgedragen. Dit is met name geschikt wanneer beslissingen afhankelijk zijn van recente gebeurtenissen, zoals bij realtime monitoring of gebeurtenisgestuurde applicaties.
Streaming is niet automatisch beter. Het brengt extra infrastructuur en operationele complexiteit met zich mee, dus de businesscase moet bepalen of de lagere latentie daadwerkelijk waardevol is.
3. opslagruimte
Opslag bewaart de binnenkomende gegevens en de bijbehorende metadata. Objectopslag is gebruikelijk omdat het grote datasets en meerdere bestandstypen kan verwerken zonder dat elk bestand aan hetzelfde schema hoeft te voldoen.
Opslagkosten vormen echter slechts een deel van de economische aspecten. Verwerking, gegevensoverdracht, beveiliging, monitoring, beheer en query's kunnen ook aanzienlijk bijdragen aan de totale kosten van het beheren van een data lake.
4. Verwerken
Verwerking zet opgeslagen gegevens om in een vorm die geschikt is voor een specifiek gebruik. Een bedrijf zou bijvoorbeeld het volgende kunnen doen:
- Verwijder dubbele records
- Tijdstempels standaardiseren
- Koppel klant-ID's in verschillende systemen.
- Sentimentanalyse uitvoeren op ondersteuningsgesprekken
- Zet gebeurtenissen om in gedragskenmerken.
- Geaggregeerde transacties
- Bereid trainingsgegevens voor een machine learning-model voor.
De ruwe bron kan behouden blijven, terwijl deze transformaties worden gecreëerd voor specifieke analytische doeleinden.
5. Bestuur
Governance bepaalt of mensen de gegevens daadwerkelijk kunnen vertrouwen en veilig kunnen gebruiken.
Het kan omvatten:
- Gegevenscatalogi
- Eigendomsgegevens
- Gegevenslijn
- Kwaliteitscontroles
- Toegangscontrole
- Privacyregels
- Bewaarbeleid
- audit trails
Dit is met name belangrijk wanneer de data lake klantgegevens bevat. Het centraal opslaan van gegevens ontslaat de betrokkenen niet van de verplichtingen op het gebied van privacy, beveiliging of naleving van regelgeving.
6. Consumptie
De consumptielaag is de plek waar opgeslagen data bruikbaar wordt. Verschillende gebruikers kunnen dezelfde onderliggende informatie gebruiken via:
- BI-dashboards
- SQL queries
- Analytische toepassingen
- Machine learning-pijplijnen
- Data science-notitieboeken
- Operationele toepassingen
Een data lake is pas succesvol als deze laag leidt tot nuttige analyses of acties. Grote hoeveelheden opgeslagen data zijn op zichzelf geen resultaat.
Data Lake versus datawarehouse
Data lakes en data warehouses lossen verwante, maar verschillende problemen op. Een warehouse is over het algemeen ontworpen rond gestructureerde, herhaalbare analytische vragen, terwijl een lake meer flexibiliteit biedt voor ruwe, gevarieerde en verkennende data.
| Kenmerk | Datameer | Datawarehouse |
| Gegevens geaccepteerd | Gestructureerd, semi-gestructureerd, ongestructureerd | Primair gestructureerd |
| Gegevensstatus | Vaak in onbewerkte vorm bewaard. | Gereinigd en getransformeerd |
| Wanneer structuur wordt toegepast | Doorgaans tijdens analyse of transformatie. | Voor of tijdens het laden |
| Veelvoorkomende gebruikers | Datawetenschappers, ingenieurs, analisten | Analisten, business teams |
| Typische sterkte | Verkenning en gevarieerde gegevens | Consistente rapportage en analyses |
| Prestaties opvragen | Afhankelijk van de architectuur en de werklast. | Meestal geoptimaliseerd voor terugkerende zoekopdrachten. |
| Veelvoorkomende gebruikssituaties | AI, onderzoek, gedragsgegevens | BI, financiële rapportage, operationele analyse |
Het verschil wordt duidelijker wanneer je kijkt naar de vragen die elk systeem moet beantwoorden.
Een magazijn is bij uitstek geschikt voor vragen als:
- Wat waren de verkopen per regio in het afgelopen kwartaal?
- Welke productcategorie genereerde de hoogste winstmarge?
- Hoe is het klantverloop het afgelopen jaar veranderd?
Deze vragen zijn van tevoren bekend, zodat de gegevens daarop kunnen worden afgestemd en geordend.
Een 'meer' is nuttiger wanneer het bedrijf informatie wil onderzoeken die niet netjes in de vooraf gedefinieerde structuren past.
Bijvoorbeeld:
- Bevatten gesprekken met de klantenservice signalen die wijzen op klantverlies?
- Heeft productgebruik invloed op verlenging van het abonnement?
- Welke reeks websiteacties is gekoppeld aan conversie?
- Kunnen gespreksopnames nuttige informatie opleveren voor een verkoopvoorspellingsmodel?
Veel organisaties gebruiken daarom beide. Het datawarehouse ondersteunt de bestaande rapportage, terwijl het datalake een bredere omgeving biedt voor onderzoek, machine learning en diverse data.
Belangrijke opmerking: Een data lake is een analytische dataomgeving. Het kan klantgegevens opslaan en verwerken, maar het vervangt niet de operationele functies die leads, deals, cases, campagnes of klantinteracties beheren – zoals een... CRM kan.
Voordelen van een Data Lake
De belangrijkste reden om een data lake te bouwen is niet alleen de hoeveelheid data die het kan bevatten. De waarde ervan schuilt in het bewaren van verschillende soorten informatie en het analyseren ervan om vragen te beantwoorden die bestaande operationele systemen niet efficiënt kunnen beantwoorden.
Schaalvergroting zonder elke bron opnieuw te ontwerpen
Een data lake kan groeiende hoeveelheden data verwerken zonder dat elke nieuwe dataset hoeft te voldoen aan een bestaand relationeel schema.
Dat is handig wanneer een bedrijf het volgende toevoegt:
- Een nieuwe applicatie
- Een nieuw product
- Een nieuw klantkanaal
- Een overgenomen bedrijf
- Een nieuwe bron van gedragsgegevens
De nieuwe bron kan worden opgenomen en gecatalogiseerd zonder eerst alle bestaande analysetabellen opnieuw te hoeven ontwerpen.
Ondersteuning voor verschillende gegevenstypen
Veel nuttige zakelijke signalen komen niet in keurige rijen en kolommen binnen.
Een meer kan het volgende bevatten:
- Oproepopnames
- Ondersteunende transcripten
- Productafbeeldingen
- Documentatie
- Website-evenementen
- Applicatielogboeken
- IoT-telemetrie
Deze bronnen kunnen later worden omgezet in kenmerken of datasets voor specifieke analytische doeleinden.
Een flexibele basis voor AI en machine learning
AI-projecten vereisen vaak historische gegevens uit meerdere bronnen. Een data lake kan een centrale omgeving bieden voor het opslaan van die informatie en het voorbereiden ervan voor modelontwikkeling.
Maar meer data leidt niet automatisch tot betere AI.
De gegevens moeten nog worden:
- Relevant voor de voorspelling
- Correct gelabeld waar nodig
- Voldoende consistent om te analyseren
- Representatief voor de populatie die wordt gemodelleerd.
- Goed bestuurd
- Toegankelijk voor de modelleringsworkflow
Het voordeel van een meer is dat het een breder scala aan potentiële signalen kan opslaan voordat het bedrijf weet welke signalen bruikbaar zullen blijken.
Verminder de hoeveelheid analytische data in afzonderlijke datasilo's.
Een meer kan informatie uit verschillende systemen samenbrengen in een gemeenschappelijke analyseomgeving.
Een detailhandelaar zou bijvoorbeeld de volgende elementen kunnen combineren:
Transacties + websitegedrag + marketingbetrokkenheid + klantenservice
in plaats van vier systemen om vier afzonderlijke rapporten te vragen.
Dat lost niet alle integratieproblemen op, maar het kan wel het aantal herhaalde exporten en handmatige afstemmingen voor analytische workloads verminderen.
Verwar opslagruimte niet met gebruiksgemak: Een datameer kan een 'datamoeras' worden wanneer datasets slecht gedocumenteerd, moeilijk te vinden, onbetrouwbaar of duur zijn om te doorzoeken. Governance, catalogisering, kwaliteitscontrole en eigendom zijn daarom onderdeel van de architectuur in plaats van optioneel opruimwerk.
Gebruiksscenario's voor datameren
Data lakes worden waardevol wanneer een bedrijf informatie moet analyseren die te gevarieerd, te omvangrijk, te historisch of te verspreid is om efficiënt te kunnen worden verwerkt door de bestaande systemen.
Systeemoverkoepelende analyses
Een meer kan informatie combineren van systemen die ontworpen zijn voor verschillende operationele doeleinden.
Een bedrijf zou bijvoorbeeld het volgende kunnen analyseren:
- Aankoop geschiedenis
- Website-activiteit
- Marketingbetrokkenheid
- Ondersteun interacties
- Productgebruik
in één enkele analytische workflow.
Dit kan verbanden aan het licht brengen die moeilijk te identificeren zijn wanneer elk systeem afzonderlijk wordt geanalyseerd.
Machine learning en AI
Een meer kan een centrale omgeving bieden voor het voorbereiden van historische gegevens voor machinaal leren.
Mogelijke toepassingen zijn onder meer:
- Churn-voorspelling
- Eis voorspelling
- Aanbevelingssystemen
- Fraude detectie
- Modellering van klantvoorkeuren
- Predictief onderhoud
Het meer creëert niet zelf het model. Het biedt opslagruimte en toegang tot de gegevens die nodig zijn om modellen te bouwen, te testen en te verbeteren.
Analyse van klantgedrag
Operationele CRM-systemen leggen doorgaans de informatie vast die nodig is om klantrelaties te beheren. Een meer kan een bredere stroom van gedragsgebeurtenissen bevatten.
Deze kunnen zijn:
- Website-trajecten
- Zoekactiviteit
- Sessie-evenementen
- Winkelwagen verlaten
- Productgebruik
- E-mailinteracties
- Ondersteunende activiteit
Door deze gebeurtenissen over een langere periode te analyseren, kunnen bedrijven patronen ontdekken die niet zichtbaar zijn in individuele CRM-records.
Gegevensconsolidatie na overnames
Na overnames beschikken bedrijven vaak over meerdere CRM-, ERP-, analyse- en operationele systemen. Een data lake kan een gemeenschappelijke analyseomgeving bieden zonder dat alle bestaande systemen direct gemigreerd hoeven te worden. Dit kan handig zijn wanneer het directe doel is om het gecombineerde bedrijf te analyseren, terwijl de consolidatie van systemen op de lange termijn nog in de planning zit.
Hoe data lakes AI-gestuurde CRM ondersteunen
Een CRM-systeem bevat de informatie die een bedrijf nodig heeft om klantrelaties te beheren. Een data lake kan een veel bredere geschiedenis bevatten van klantgedrag, productgebruik, digitale activiteiten en interacties.
Door de twee te verbinden, kunnen AI-systemen dus extra signalen krijgen om te analyseren. Maar de data lake verbetert een CRM-model niet automatisch. De data moet eerst relevant zijn, gekoppeld aan de juiste klant of account, beheerd worden en beschikbaar zijn voor de modellering of operationele workflow.
Voeg context toe die verder gaat dan het CRM-record.
De CRM-databasestructuur Kan contactgegevens, transactiegeschiedenis, activiteiten, rechtszaken en andere relatiegegevens bevatten.
Een data lake kan informatie toevoegen die het CRM-systeem normaal gesproken niet volledig bewaart, zoals:
- Gedetailleerde website-evenementen
- Productgebruik
- Oproepopnames
- Applicatielogboeken
- Historische gedragsgebeurtenissen
Gezamenlijk kunnen deze bronnen een breder beeld geven van wat er vóór, tijdens en na een klantinteractie is gebeurd.
Voorspellende modellen relevantere signalen geven
Voorspellende AI-modellen Men kan historische patronen gebruiken om waarschijnlijke uitkomsten te schatten.
Een churn-model zou bijvoorbeeld rekening kunnen houden met klantondersteuningsactiviteiten, productgebruik, betrokkenheid en aankoopgeschiedenis, in plaats van te vertrouwen op slechts één signaal.
Het sleutelwoord is relevantie. Het toevoegen van duizenden ongerelateerde velden kan de complexiteit verhogen zonder de voorspellingskracht te verbeteren. Goede AI is afhankelijk van bruikbare signalen, schone data, een passende modellering en continue evaluatie.
Verbeter de klantsegmentatie
Klantsegmentatiemodellen kan meer op gedrag gericht worden wanneer er aanvullende klantenevenementen beschikbaar zijn.
In plaats van klanten alleen te groeperen op basis van wat ze hebben gekocht, kan een bedrijf onderscheid maken tussen klanten die:
- Ik bekijk regelmatig mijn website, maar koop zelden iets.
- Koop regelmatig en neem deel aan campagnes.
- Ik gebruik een product veel, maar heb het gebruik ervan de laatste tijd verminderd.
- Neem herhaaldelijk contact op met de klantenservice voordat u uw abonnement verlengt.
Deze patronen kunnen leiden tot effectievere targeting dan segmenten gebaseerd op demografische gegevens of alleen transacties.
Lever betere input aan CRM-automatisering
AI CRM-mogelijkheden Klant- en interactiegegevens kunnen worden gebruikt ter ondersteuning van aanbevelingen, voorspellingen en andere geautomatiseerde workflows.
De analytische laag en het CRM-systeem hebben nog steeds verschillende taken.
Het data lake kan helpen bij het voorbereiden en analyseren van grotere datasets. Het CRM is de plek waar de verkregen inzichten operationeel worden gemaakt, bijvoorbeeld om een klant te identificeren die aandacht nodig heeft of om een vervolgactie aan te bevelen.
Die laatste stap is cruciaal. Een inzicht dat binnen een analytische omgeving blijft, verbetert de klantervaring pas als iemand of iets er actie op kan ondernemen.
Voordat je een data lake bouwt: Controleer of het probleem daadwerkelijk een data lake vereist. Als uw bedrijf zijn rapportage- en klantbeheervragen kan beantwoorden met een bestaand CRM-systeem, datawarehouse, BI-platform of directe integraties, kan een data lake onnodige opslag-, engineering-, beveiligings- en governance-werkzaamheden met zich meebrengen.
Een data lake implementeren
Een data lake-project moet beginnen met de zakelijke vragen die beantwoord moeten worden, niet met een beslissing over hoeveel opslagruimte er nodig is. De meest nuttige implementaties zorgen er ook voor dat governance en verantwoordelijkheid al vroeg worden vastgelegd, in plaats van dit als een latere opruimactie te beschouwen.
Begin met concrete vragen.
Definieer de eerste gebruiksscenario's voordat u gegevens verzamelt.
Bijvoorbeeld:
- Welke klanten zullen waarschijnlijk opzeggen?
- Welk productgedrag voorspelt verlenging?
- Welke campagne-interacties beïnvloeden de conversie?
- Welke steunpatronen duiden op ontevredenheid?
Een duidelijke vraag helpt bepalen welke bronnen daadwerkelijk tot de eerste versie van het meer behoren.
Catalogiseer gegevens vanaf het begin.
Elke dataset moet basisinformatie bevatten over:
- Wat het bevat
- Waar het vandaan kwam
- Wie is de eigenaar?
- Hoe vaak het wordt bijgewerkt
- Hoe betrouwbaar het is
- Wie heeft er toegang toe?
Zonder deze informatie wordt een steeds groter wordende verzameling bestanden moeilijk te interpreteren.
Pas beveiligings- en toegangscontroles toe.
Klant- en werknemersgegevens kunnen persoonsgegevens of andere gevoelige informatie bevatten.
Toegangsbeleid moet daarom het volgende bepalen:
- Wie heeft toegang tot elke dataset?
- Welke velden vereisen extra bescherming?
- Hoe lang moet informatie bewaard worden?
- Hoe wordt het datagebruik gecontroleerd?
- Hoe gevoelige informatie wordt afgeschermd of beperkt
De beheersmaatregelen moeten van toepassing zijn op het meer als onderdeel van de bredere dataomgeving, en niet als een bijzaak.
Hetzelfde principe geldt voor CRM-omgevingen. Bijvoorbeeld: CRM-beveiligingsinstellingen zijn ontworpen om de toegang tot klant- en bedrijfsgegevens te beperken volgens de behoeften van de organisatie.
Kies voor batchverwerking of streaming, afhankelijk van uw behoeften.
Kies niet voor streaming alleen omdat het geavanceerder klinkt. Batchverwerking kan volstaan wanneer het bedrijf dagelijkse of uurlijkse veranderingen analyseert. Streaming wordt waardevoller wanneer beslissingen afhangen van gebeurtenissen die binnen seconden of minuten binnenkomen. De juiste keuze hangt af van de zakelijke gevolgen van latentie.
Gebruik en bedrijfsresultaten meten
Een data lake moet worden beoordeeld op basis van de resultaten, niet op basis van de opslagcapaciteit.
Nuttige maatregelen zijn onder meer:
- Aantal actieve analytische gebruiksscenario's
- Gebruik van query's of datasets
- Benodigde tijd voor het voorbereiden van de gegevens
- Vermindering van handmatige afstemming
- Modelprestaties
- Tijd bespaard door rapportage
- Impact op omzet of klantbehoud, indien meetbaar
Een datameer vol petabytes aan data, maar dat geen zinnige beslissingen ondersteunt, is geen succesvol dataplatform.
Hoe Vtiger CRM-gegevens omzet in actie
Een data lake en een CRM hebben verschillende functies. Een data lake ondersteunt bredere analytische taken, terwijl een CRM teams helpt bij het beheren van klantgegevens, verkoopactiviteiten, service-interacties en follow-ups. Vtiger richt zich op het omzetten van de reeds beschikbare data in het CRM in bruikbare beslissingen. Vtiger's Reken AI Het maakt gebruik van CRM-gegevens en klantinteracties om voorspellende inzichten en aanbevelingen te genereren. Het ondersteunt functionaliteiten zoals voorspellende leadscoring, verkoopprognoses, gespreksanalyse en aanbevelingen voor de beste volgende actie.
Veelgestelde vragen (FAQ's)
Vraag 1. Wat is een data lake?
Een data lake is een gecentraliseerde opslagomgeving voor grote hoeveelheden gestructureerde, semi-gestructureerde en ongestructureerde data. Het kan data in zijn oorspronkelijke vorm bewaren en later, wanneer de informatie gereed is voor analyse, structureren.
Vraag 2. Wat zijn de voordelen van een data lake?
Een data lake kan verschillende gegevenstypen opslaan, grote volumes verwerken, historische informatie bewaren voor analyse en een gemeenschappelijke omgeving bieden voor gegevens uit meerdere systemen. Deze voordelen zijn afhankelijk van effectief beheer, beveiliging, catalogisering en datakwaliteit.
Vraag 3. Wat zijn veelvoorkomende gebruiksscenario's voor data lakes?
Veelvoorkomende toepassingen zijn onder andere systeemoverkoepelende analyses, machine learning, analyse van klantgedrag, vraagvoorspelling, aanbevelingssystemen en het consolideren van analytische gegevens uit meerdere bedrijfsonderdelen of verouderde systemen.
Vraag 4. Wat is het verschil tussen een data lake en een data warehouse?
Een datawarehouse slaat doorgaans gestructureerde en voorbereide data op voor vastgestelde analyse- en rapportagebehoeften. Een data lake biedt meer flexibiliteit voor ruwe en gevarieerde data, waardoor het nuttig is voor data-exploratie, machine learning en toepassingen waarbij de vereiste datastructuur niet van tevoren bekend is.
Vraag 5. Hoe ondersteunt een data lake AI?
Een data lake kan een centrale omgeving bieden voor het bewaren en voorbereiden van historische gegevens uit meerdere bronnen. Dit kan machine learning-teams toegang geven tot een breder scala aan relevante signalen, hoewel meer data niet automatisch resulteert in een beter model.
Vraag 6. Kan een data lake CRM verbeteren?
Een data lake kan aanvullende gedrags-, product- en interactiegegevens leveren die CRM-analyses en AI-modellen kunnen verrijken. De gegevens moeten relevant, betrouwbaar en correct gekoppeld zijn aan klantgegevens, beheerd worden en beschikbaar zijn voor de CRM- of modelleringsworkflow voordat ze waarde kunnen toevoegen.
Vraag 7. Wat is de rol van data lakes in AI-gestuurde CRM?
Een data lake kan dienen als een bredere analytische dataomgeving, terwijl het CRM-systeem het operationele systeem blijft voor het beheren van klantrelaties. Inzichten die worden verkregen uit bredere datasets kunnen mogelijk CRM-voorspellingen, segmentatie, aanbevelingen en andere klantgerichte acties ondersteunen.
Vraag 8. Heeft elk bedrijf een data lake nodig?
Nee. Een data lake is vooral nuttig wanneer een bedrijf grote of gevarieerde datasets heeft die bestaande systemen niet efficiënt kunnen analyseren, meerdere bronnen die gezamenlijk onderzocht moeten worden, of machine learning- en analysevereisten die de extra engineering- en beheerinspanningen rechtvaardigen.